پنج مدل کوچک Qwen در برابر Claude Fable 5: تیم ۲۷ میلیاردی در LiveCodeBench Hard جلو زد
ورکفلوی team-solve در Memdoor پنج نمونهی Qwen3.8-27B را مثل یک تیم برنامهنویسی (برنامهریز، دو ایدهپرداز، حلکننده و مدیر) کنار هم میگذارد و روی ده مسئلهی سخت LiveCodeBench میانگین ۹٫۸ از ۱۰ میگیرد، در برابر ۸ برای یک فراخوانی Claude Fable 5؛ هر اجرا حدود ۰٫۳۹ دلار.
1 Nov 2026 · 4 min read · AI · LLM · Qwen · Claude · Fable 5 · LiveCodeBench · Multi-Agent · Open Source · Memdoor · Coding Agents
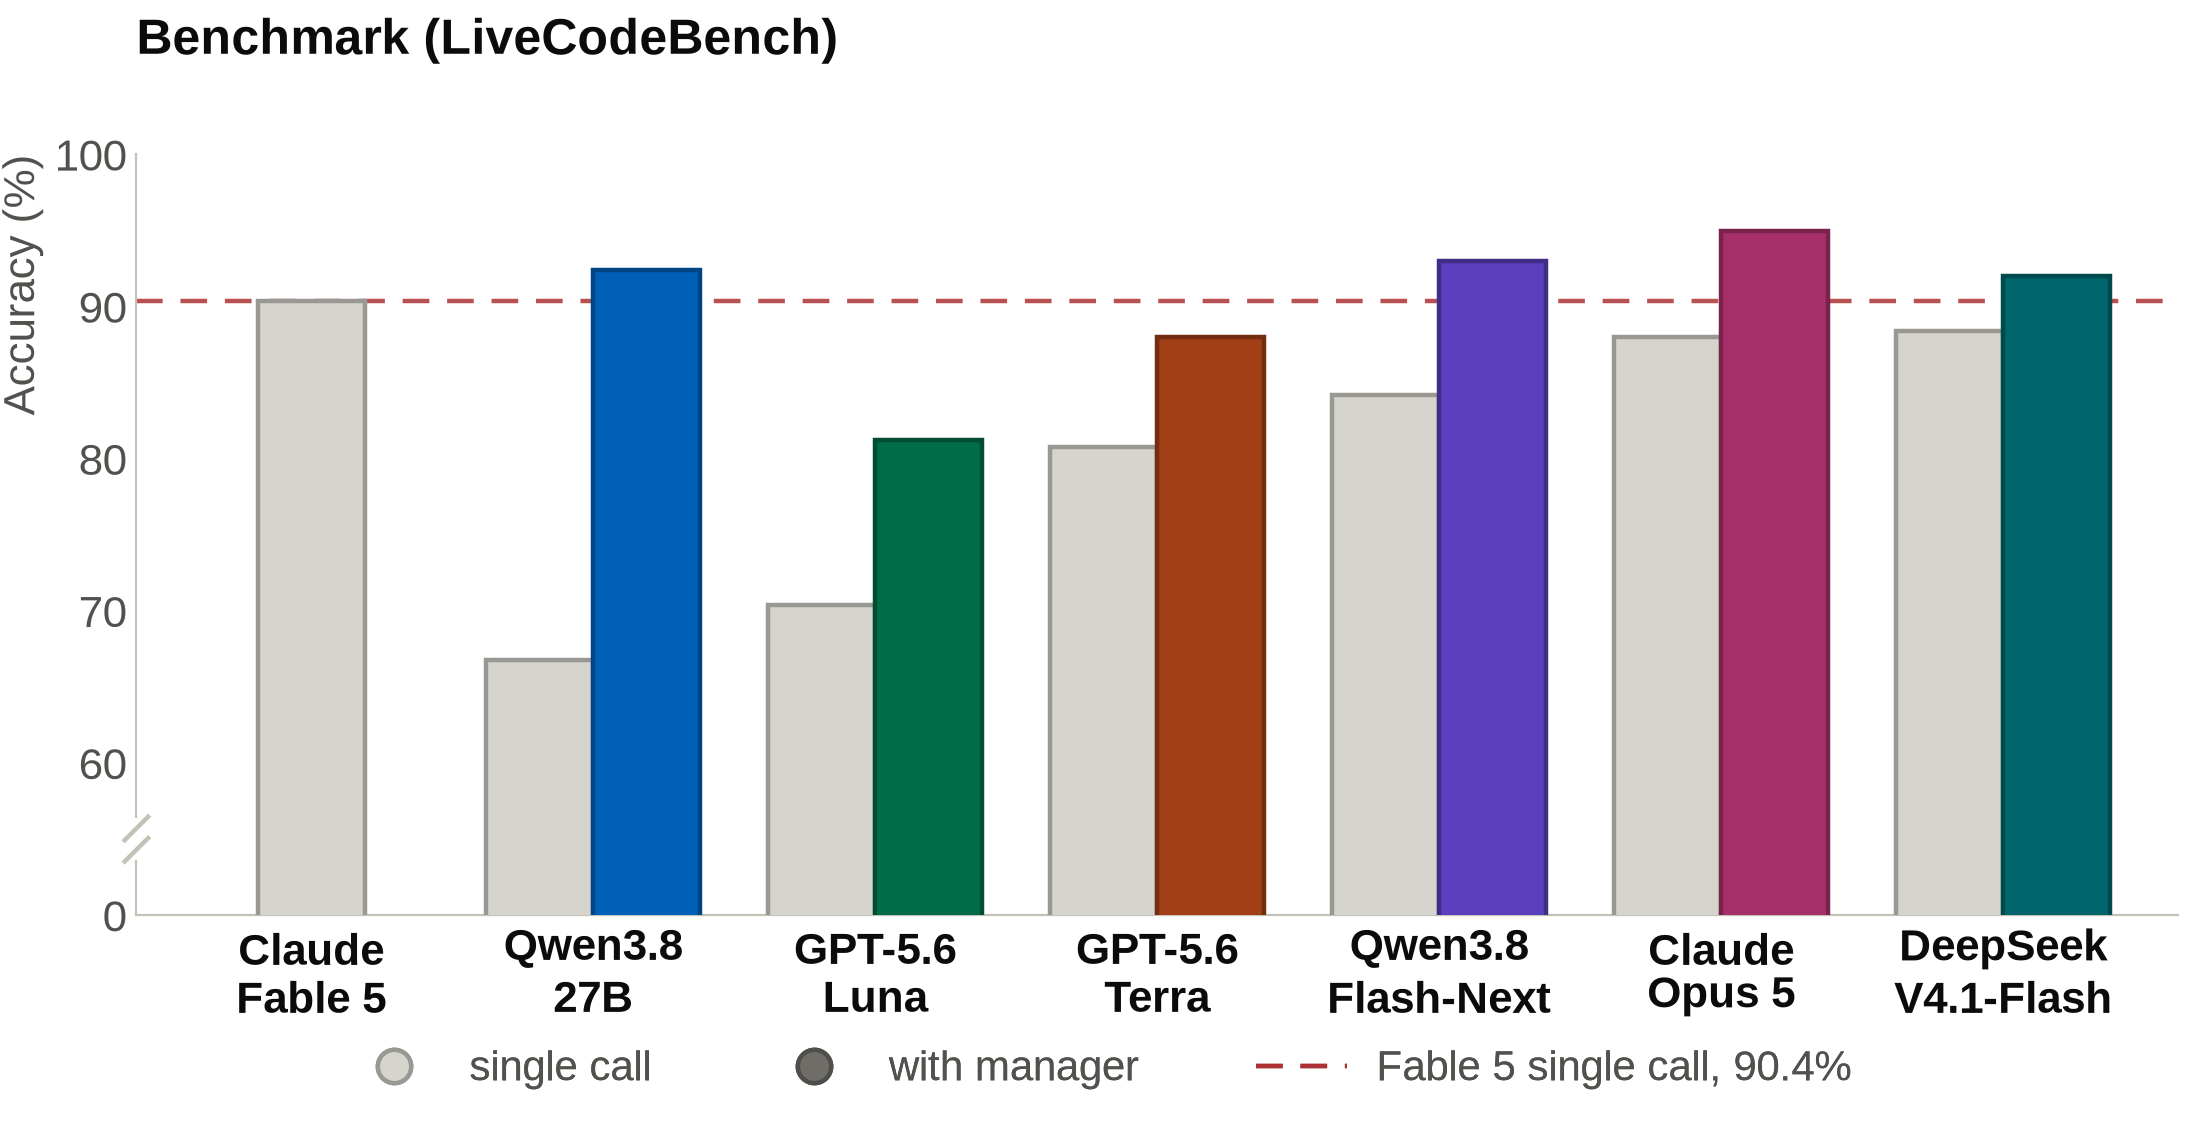
یکی از پربحثترین پستهای این روزهای Hacker News (بیش از ۳۰۰ امتیاز و ۱۴۰ کامنت) یک ادعای جسورانه دارد: پنج نمونه از یک مدل متنباز ۲۷ میلیارد پارامتری، Qwen3.8-27B، وقتی مثل یک تیم کوچک برنامهنویسی کنار هم کار کنند، روی مسئلههای سخت LiveCodeBench از Claude Fable 5 بهتر عمل میکنند. آن هم با هزینهای حدود ۰٫۳۹ دلار برای هر مسئله، و حتی با امکان اجرا روی کارت گرافیک خودتان.
ماجرا از کجا شروع شد؟
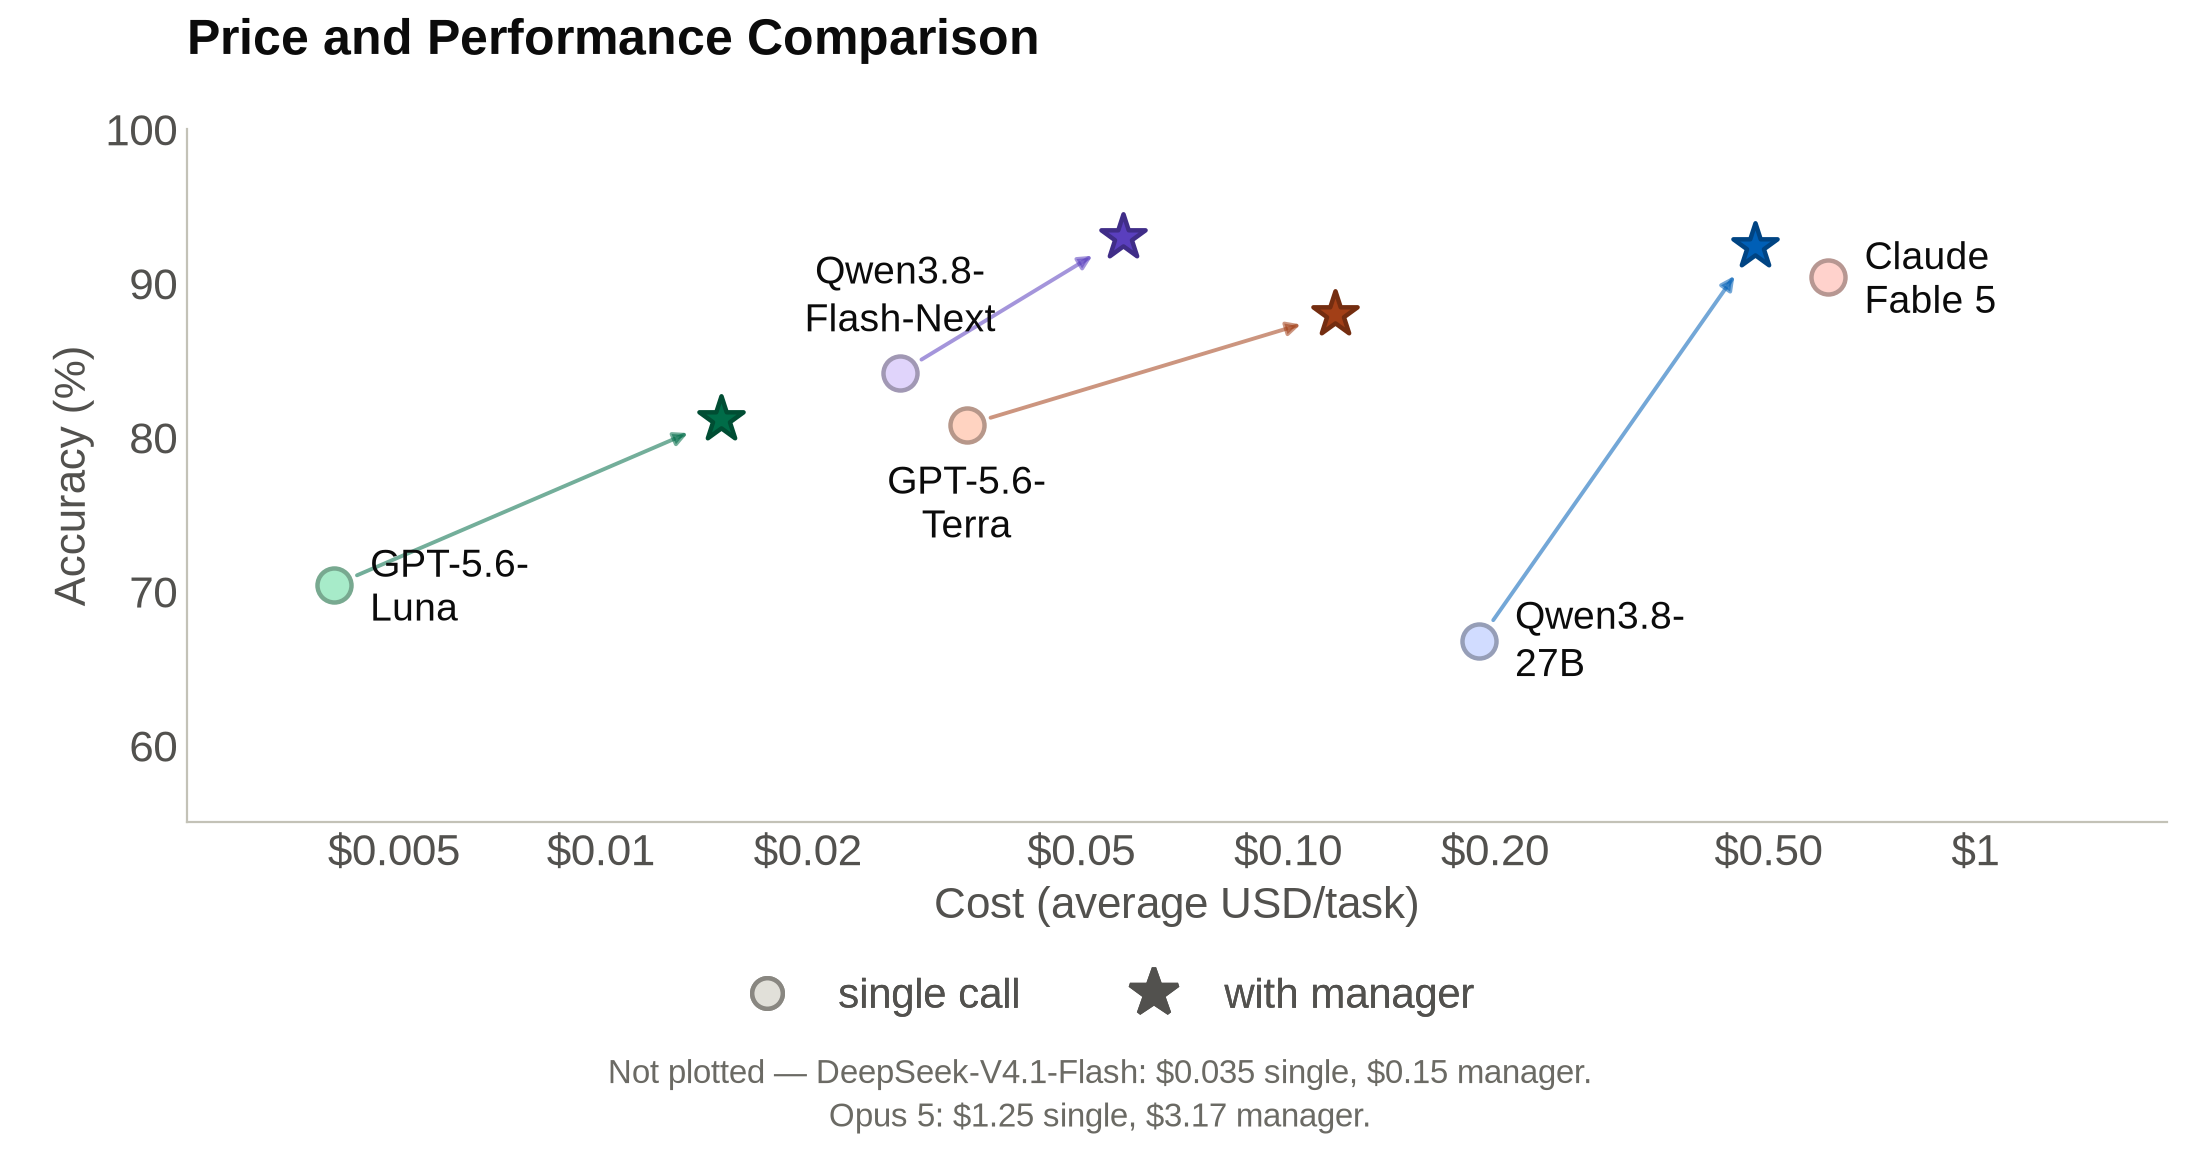
ایده مال یک مقاله است به اسم GVS5H (مخفف بامزهی «گوریل در برابر ۵ آدم») از آزمایشگاه Persis Capital. روششان را «خودسازماندهی مبتنی بر دفتر کل» (ledger-based self-orchestration) نامیدهاند: بدون هیچ آموزش اضافه، چند نمونهی تازه از یک مدل مسئله را تقسیم میکنند و فقط از طریق فایلهای مشترک روی دیسک با هم حرف میزنند؛ یک برنامه، یک دفترچهی یادداشت و راهحل فعلی. طبق مقاله، روی ۱۰۰ مسئلهی سخت اخیر LiveCodeBench، مدل Qwen3.8-27B که بهتنهایی ۶۶٫۸٪ میگرفت با این روش به ۹۲٫۴٪ رسیده، و Qwen3.8 Flash Next به ۹۳٪، در برابر ۹۰٫۴٪ برای Fable 5، با حدود ۹٪ هزینه.
Memdoor چه کرد؟
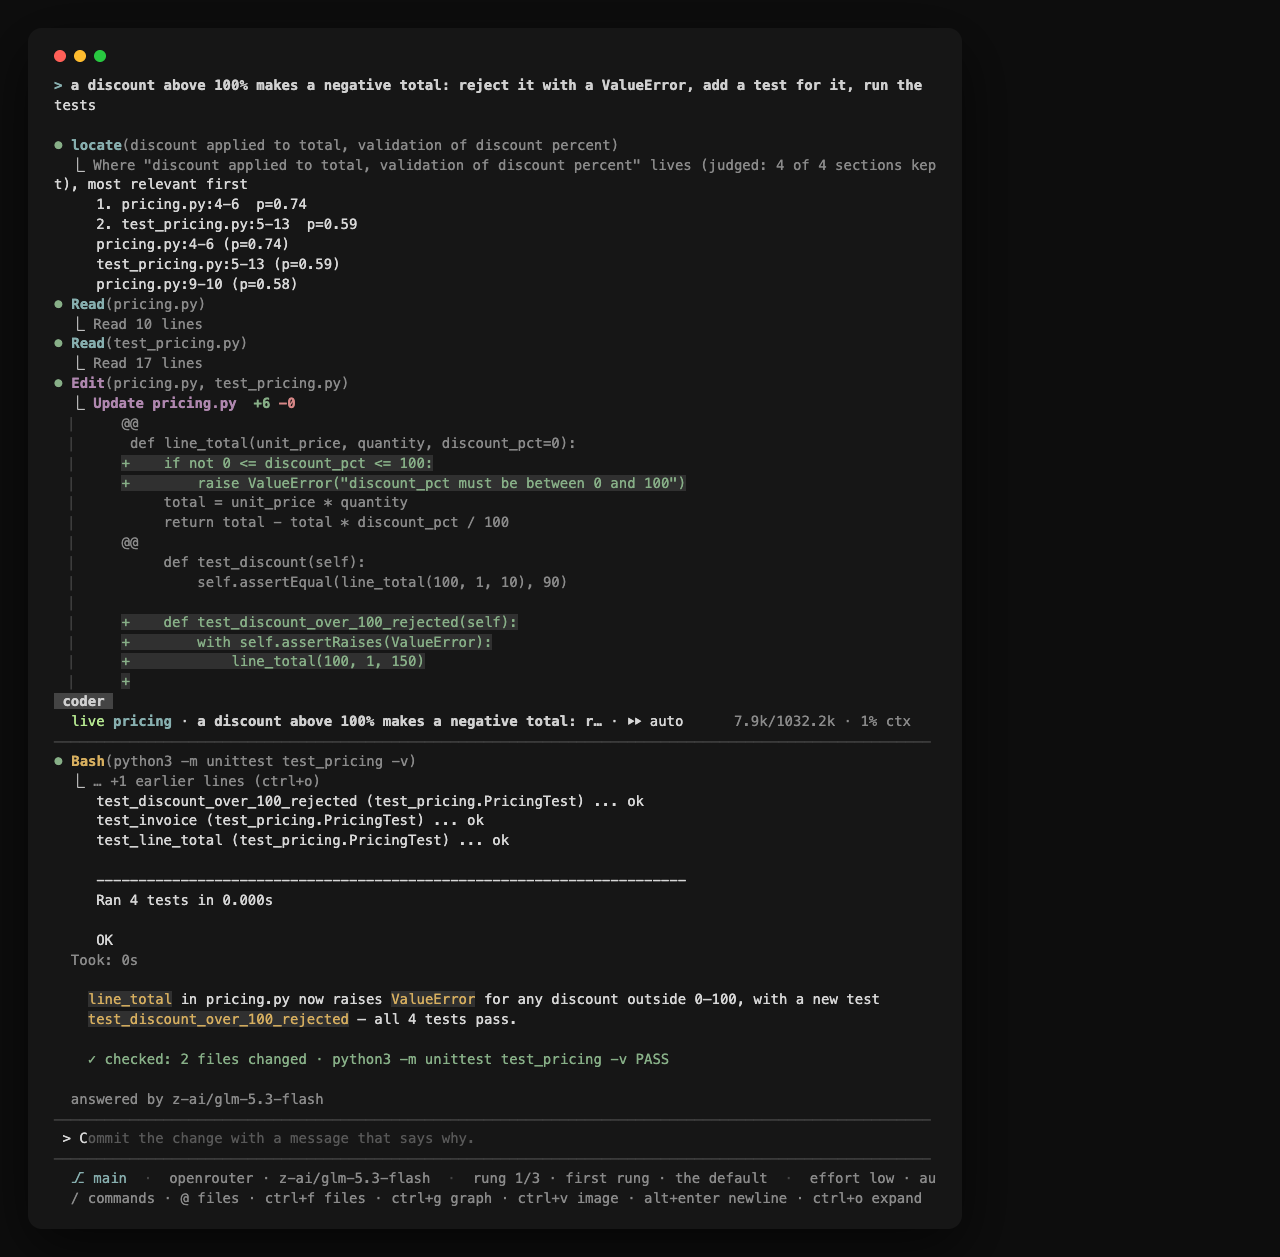
پروژهی متنباز Memdoor (یک ایجنت برنامهنویسی سبک در قالب یک باینری Go) همین روش را دقیقاً با پرامپتها و حلقهی نویسندگان مقاله، به شکل یک ورکفلو به اسم team-solve بازسازی کرده: فقط هشت فایل YAML، بدون کد، و بدون اینکه اسم هیچ مدلی در آن آمده باشد. نقشها اینها هستند:
- برنامهریز مسئله را میخواند و plan مینویسد.
- دو ایدهپرداز بهصورت موازی دو الگوریتم از دو خانوادهی متفاوت پیشنهاد میدهند.
- حلکننده بین دو پیشنهاد انتخاب میکند و
solution.pyرا مینویسد. - بعد تست روی نمونهها اجرا میشود، مدیر نتیجه را بررسی میکند و یک تعمیرکار باگها را درست میکند.
هر نقش با کانتکست خالی شروع میکند و قانونش این است: «فایلها را بخوان، به چت تکیه نکن». و نکتهی مهم: اینکه مسئله حل شده یا نه را یک اسکریپت تعیین میکند، نه یک مدل.
نتیجه، با همهی اماواگرهایش
روی ده مسئلهی اول فهرست LiveCodeBench Hard مقاله، هر کدام پنج بار، این ورکفلو میانگین ۹٫۸ از ۱۰ گرفته؛ هارنس خود نویسندگان ۹٫۶ و Fable 5 با یک فراخوانی ۸. هر اجرا بهطور میانه ۴۰ دقیقه طول کشیده و ۰٫۳۹ دلار خرج داشته و کل ۵۰ اجرا ۳۵٫۷۹ دلار. خوبی کارشان این است که خودشان صادقانه محدودیتها را نوشتهاند:
- فقط ده مسئله است، نه صد؛ خودشان میگویند ۹٫۸ و ۹٫۶ عملاً یک عددند و ادعا «برابری» با مقاله است، نه پیشرفت.
- مسئلهها مال بهار ۲۰۲۵ هستند و ممکن است در دادهی آموزشی مدل بوده باشند.
- ستون Fable 5 در این هارنس اجرا نشده و از فایلهای مقاله آمده.
- مدل روی OpenRouter اجرا شده، نه روی ماشین محلی.
همهی ۵۰ اجرا با تکتک درخواستها، پاسخها، برنامهها و خروجی grader منتشر شدهاند. اگر بخواهید خودتان امتحان کنید، ورکفلو را میشود به هر مدلی وصل کرد، از جمله یک مدل محلی روی Ollama، llama.cpp یا vLLM.
نظر من
به نظرم مهمترین پیام این خبر «Qwen از Claude بهتر است» نیست؛ با ده مسئله و احتمال آلودگی داده، چنین ادعایی را نباید جدی گرفت. پیام واقعی این است که طراحی سازمان کار دارد به اندازهی خود مدل مهم میشود. مدلی که بهتنهایی ۶۷٪ میگیرد، وقتی کار را تقسیم کند، برای هر نقش کانتکست تمیز داشته باشد و حافظهاش را روی فایل نگه دارد، تا نزدیک ۹۲٪ بالا میرود. این همان چیزی است که در تیمهای انسانی هم میبینیم: چند آدم معمولی با فرایند خوب، خیلی وقتها از یک نابغهی تنها جلو میزنند.
برای ما که هزینهی API و تحریم و دسترسی برایمان مسئله است، این خبر خوبی است: اگر یک مدل متنباز ۲۷ میلیاردی روی یک GPU خانگی با کمی مهندسی هارنس به سطح مدلهای frontier نزدیک شود، کلی در باز میشود. البته هزینهاش زمان است؛ ۴۰ دقیقه برای یک مسئله برای کار روزمره زیاد است. ولی جهت حرکت را خوب نشان میدهد: آیندهی ایجنتهای برنامهنویسی احتمالاً «یک مدل غولپیکر» نیست، «یک تیم کوچک و منظم» است.
منبع: Memdoor — team-solve | GVS5H روی GitHub | صفحهی نتیجه در memdoor.ai | بحث در Hacker News
Comments +
00No comments yet — be the first. هنوز نظری ثبت نشده؛ اولین نفر باش.