وقتی هوش مصنوعی برای استارکرفت ربات مینویسد: نتایج StarSkirmish Bench
در StarSkirmish Bench هر مدل زبانی یک ساعت وقت دارد با ++C یک ربات StarCraft بنویسد؛ GPT-6 Astra اول شد، GPT-6.1 Sol ارزانترین گزینهی خوب بود و Gemini 4 Argon با Claude Opus 5.5 تقریباً مساوی شد.
17 Oct 2026 · 3 min read · هوش مصنوعی · بنچمارک · StarCraft · Gemini · Claude · GPT · کدنویسی با AI · ایجنت
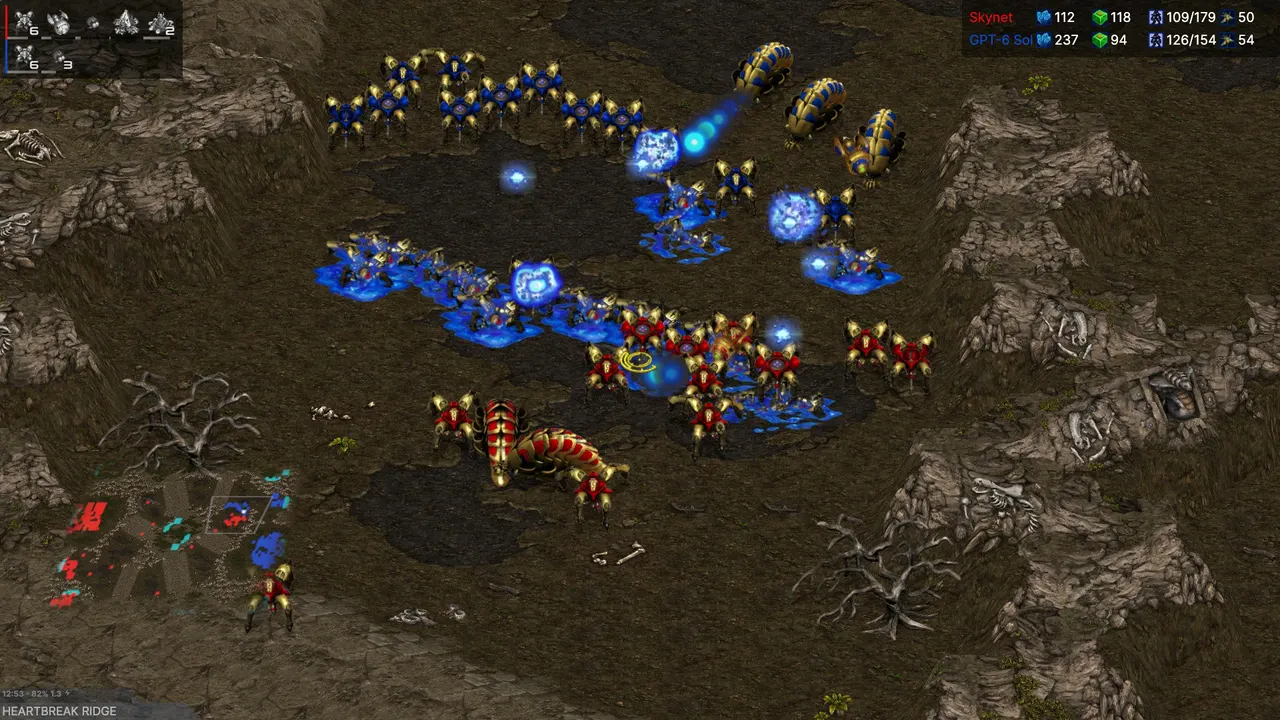
یک بنچمارک جدید و خیلی بامزه به صفحهی اول Hacker News رسیده: StarSkirmish Bench v0.2. ایده ساده است ولی سخت: به هر مدل زبانی دقیقاً یک ساعت وقت میدهند تا با ++C یک ربات Protoss برای StarCraft: Brood War بنویسد (روی BWAPI 4.4.0 و موتور متنباز OpenBW). بعد ربات نهایی هر مدل جلوی رباتهای رقابتیِ انساننوشته بازی میکند و امتیاز، میانگین درصد بردهاست.
قوانین بازی چیست؟
- هر مدل در CLI رسمی آزمایشگاه خودش اجرا شده: Claude Code برای Claude، Codex برای GPT، Antigravity CLI برای Gemini و Muse Code برای مدل متا. همه با بالاترین سطح reasoning موجود.
- نقطهی شروع یک ربات اسکلتی است که فقط معدن میکند، بهعلاوهی کد سه ربات دمو و کتابخانههای FAP (شبیهساز نبرد) و BWEM (تحلیل نقشه).
- مدل ابزار کامپایل، اجرای بازی تمرینی و خواندن لاگ و خلاصهی بازیها را دارد؛ اینترنت و جستوجوی وب خاموش است.
- هر مدل ۵ بار اجرا شده و هر ربات نهایی روی سه نقشه (Heartbreak Ridge، Benzene و Destination) جلوی ۱۳ ربات ثابت بازی کرده.
نتایج
صدرنشین GPT-6 Astra با میانگین حدود ۵۷٪ برد است و GPT-6.1 Sol با حدود ۴۶٪ دوم شده. Gemini 4 Argon (۳۹٫۳)، Claude Opus 5.5 (۳۸٫۶) و Claude Fable 5.1 (۳۷٫۲) عملاً مساویاند. ته جدول هم GPT-6 Luna با حدود ۱۳٪ است.
از نظر هزینه، GPT-6.1 Sol بهترین معامله است: رتبهی دوم با حدود ۲ دلار برای هر اجرای یکساعته، در حالی که هر اجرای GPT-6 Astra حدود ۱۸ دلار خرج دارد. Gemini 4 Argon هم با حدود ۳٫۶ دلار جایگاه سوم را گرفته، ولی پراکندگی نتایجش زیاد است: بهترین و بدترین اجرایش ۱۸ امتیاز اختلاف دارند.
دو نکتهی جالبتر از جدول
اول: قویترین پیشبینیکنندهی امتیاز، این است که مدل چقدر جلوی رباتهای قوی تمرین کرده. GPT-6 Astra در میانهی اجراهایش ۱۵۹ بازی تمرینی با ۷ ربات قوی انجام داده، در حالی که چند مدل ضعیفتر تقریباً هیچوقت سراغ حریف قوی نرفتهاند.
دوم: هنوز فاصله زیاد است. جلوی رباتهای برتر انسانی مثل Stardust، PurpleWave و BananaBrain، حتی GPT-6 Astra فقط حدود ۷٪ بازیها را میبرد. ضمناً این بنچمارک با Artificial Analysis Intelligence Index همبستگی کمی دارد (ρ حدود ۰٫۲۶)، ولی با Vals IOI و WeirdML همجهت است.
نظر من
این از آن بنچمارکهایی است که دوستشان دارم، چون تقلب در آن سخت است. اینجا جواب درست و غلط ثابتی وجود ندارد که مدل حفظ کرده باشد؛ مدل باید در یک ساعت کد ++C بنویسد، کامپایل نگه دارد، تست کند، شکست بخورد و از شکست یاد بگیرد. یعنی دقیقاً همان کاری که از یک agent کدنویس در پروژهی واقعی انتظار داریم.
برای من مهمترین درسش همان بخش تمرین است: مدلی که زودتر خودش را جلوی حریف سخت میگذارد، ربات بهتری میسازد. این برای ما برنامهنویسها هم صدق میکند؛ تست واقعی زود و زیاد، از ده دور فکر کردن در خلأ بهتر است. نکتهی دیگر هم اینکه رتبه در بنچمارکهای پرسروصدا لزوماً یعنی بهترین در کارهای طولانی و سخت نیست. اگر برای کارهای agentic مدل انتخاب میکنید، به همین تستهای کمتر «هدفگرفتهشده» بیشتر نگاه کنید. البته فراموش نکنیم این بنچمارک را یک نفر ساخته و هنوز نسخهی ۰٫۲ است، پس نتایج را جدی ولی با احتیاط بخوانید.
منبع: StarSkirmish Bench v0.2 | بحث در Hacker News
Comments +
00No comments yet — be the first. هنوز نظری ثبت نشده؛ اولین نفر باش.