Cerebras چطور مدلهای تریلیونپارامتری را سرو میکند: Kimi K3 روی ۵۹ ویفر
Cerebras با مثال Kimi K3 سهتریلیونی توضیح داد چطور یک مدل فرانتیر را روی ۵۹ ویفر با پایپلاین و بدون جابهجایی وزنها با سرعت ۱۰۰۰ تا ۲۰۰۰ توکن در ثانیه سرو میکند. خلاصه و نظر من.
25 Oct 2026 · 3 min read · Cerebras · هوش مصنوعی · Kimi K3 · inference · سختافزار · LLM
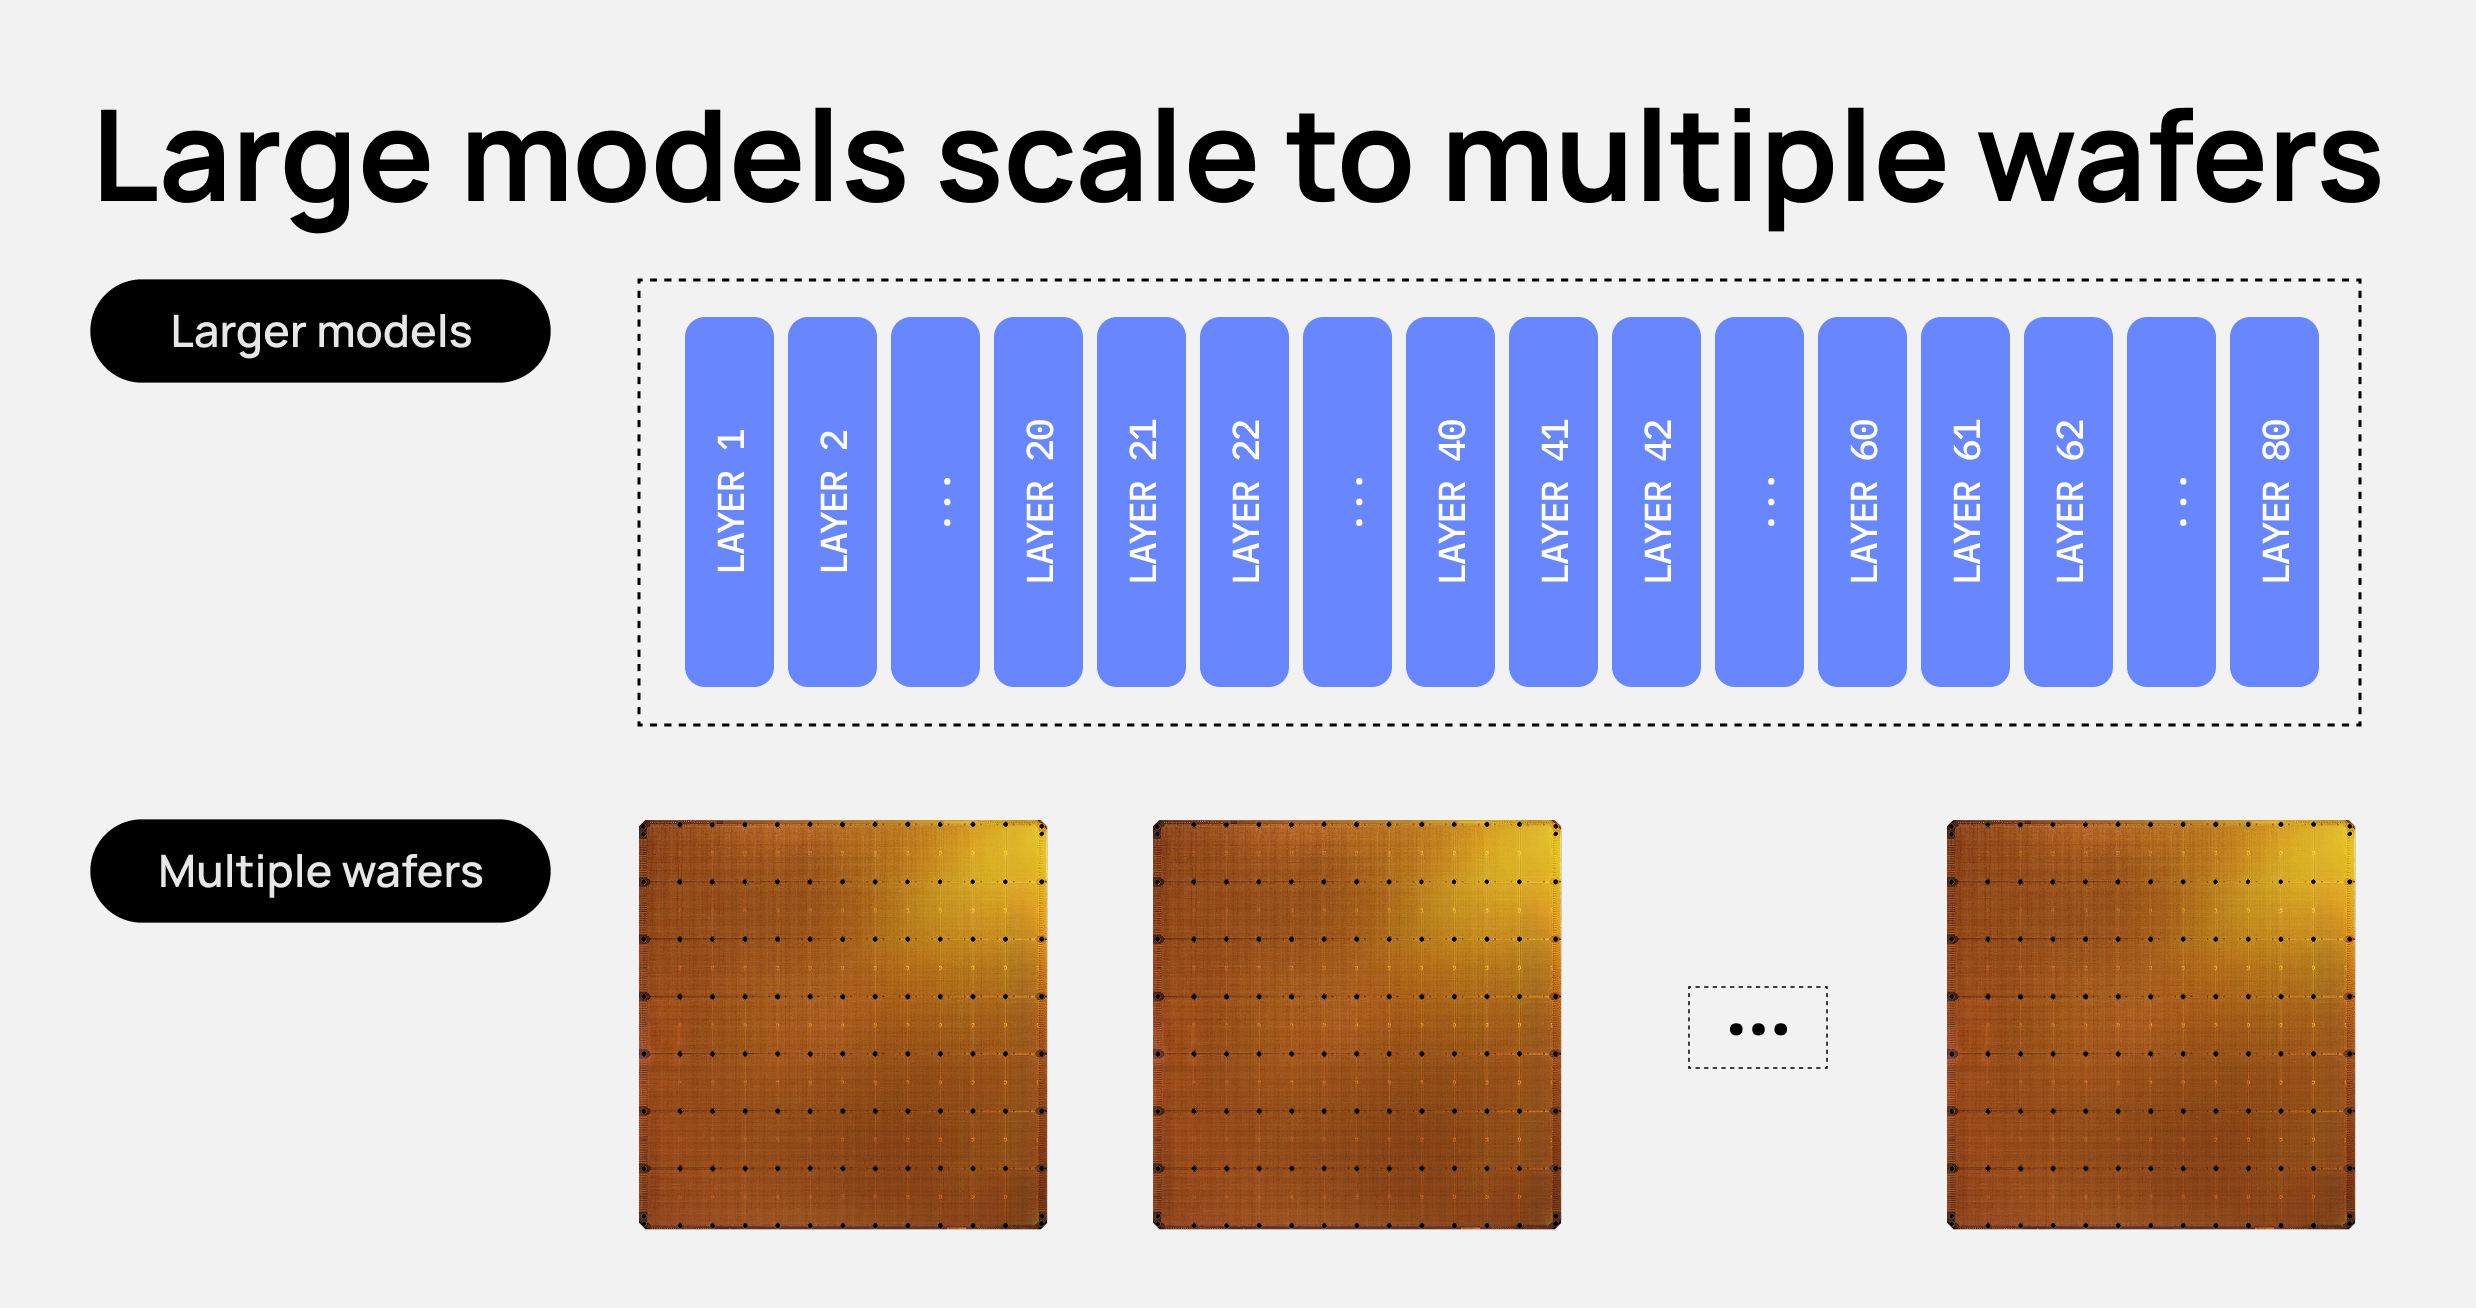
یکی از پرتکرارترین سؤالها دربارهی Cerebras این است: وقتی هر ویفر فقط ۴۴ گیگابایت حافظهی on-chip دارد، چطور مدلی با چند تریلیون پارامتر را با سرعت ۱۰۰۰ تا ۲۰۰۰ توکن در ثانیه سرو میکنند؟ Cerebras حالا در یک پست فنی جواب را با عدد و رقم داده و مثالش هم Kimi K3 است، مدل open-weight سهتریلیون پارامتری. این پست در هکرنیوز هم حسابی بالا آمد و بحث GPU در برابر wafer-scale را دوباره داغ کرد.
حسابوکتاب ساده، قدم به قدم
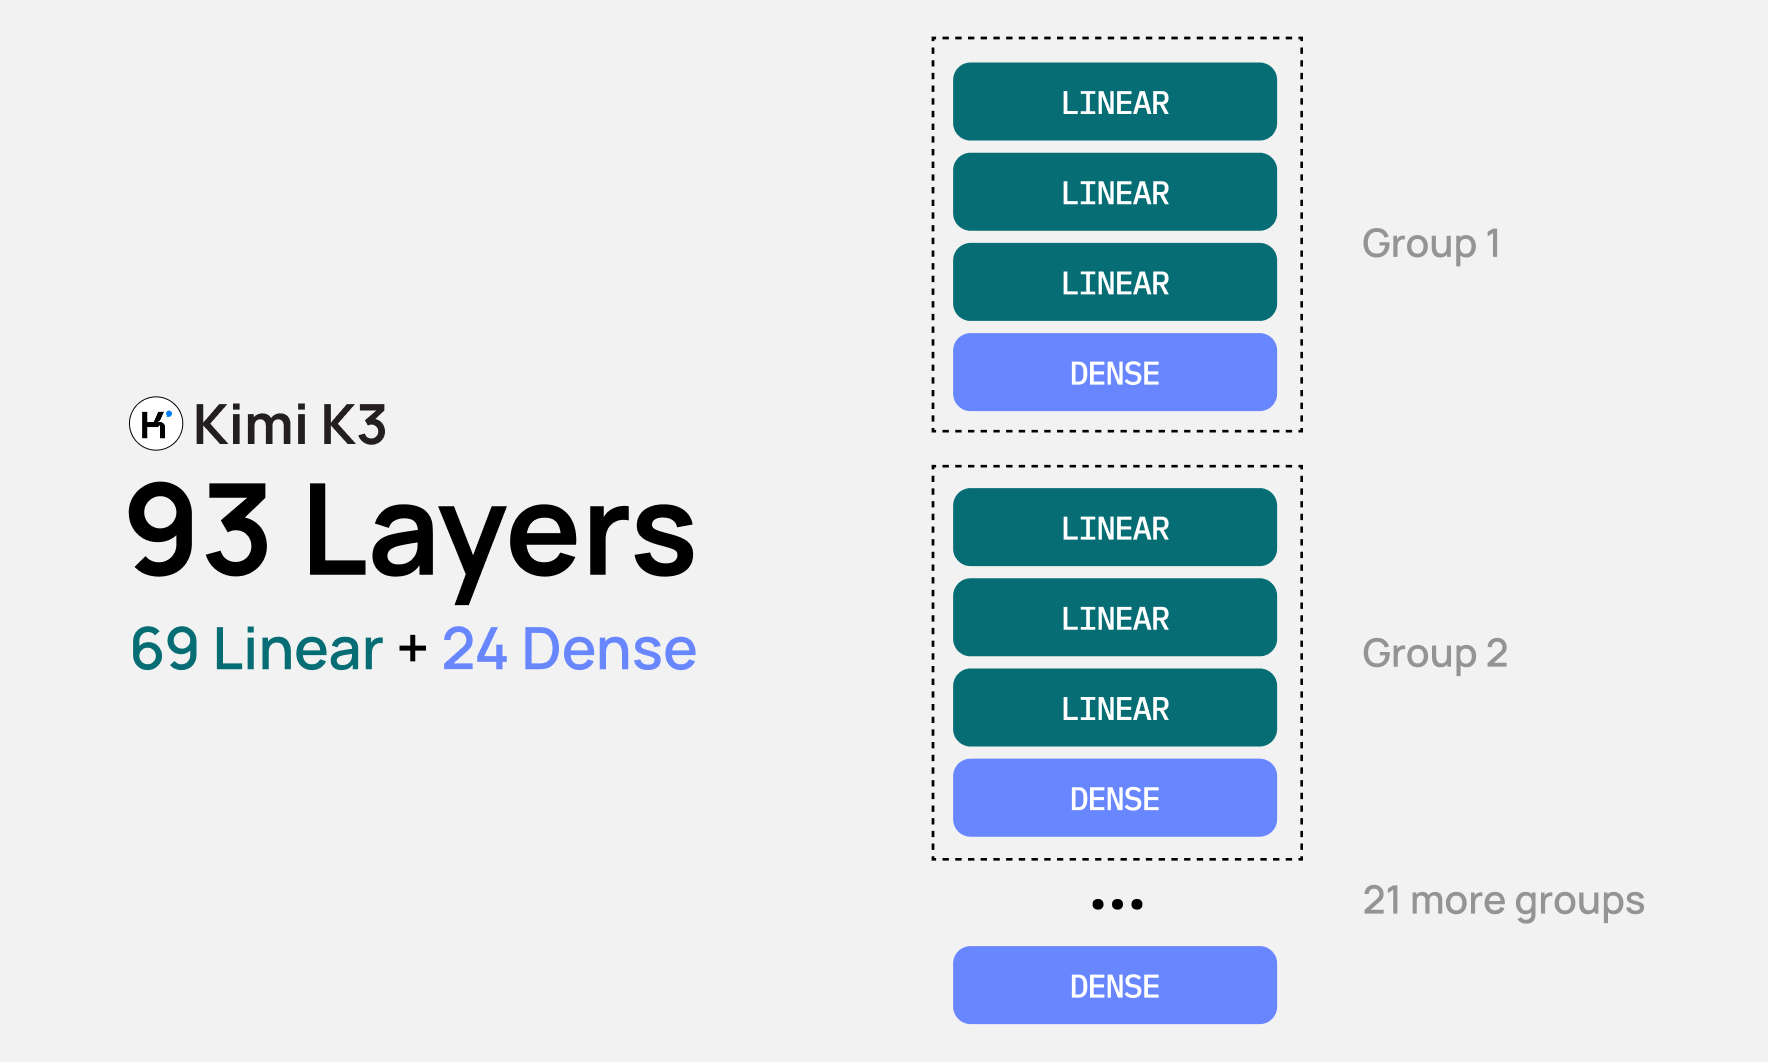
- حجم وزنها: ۳ تریلیون پارامتر با کوانتیزیشن ۴ بیتی میشود حدود ۱.۵ ترابایت. تقسیم بر ۹۳ لایه، یعنی هر لایه حدود ۱۶ گیگابایت.
- دو نوع لایه: Kimi K3 شصتونه لایهی linear-attention و بیستوچهار لایهی dense دارد. لایهی linear فقط یک state کوچک و ثابت برای هر درخواست نگه میدارد، پس دوتا روی یک ویفر جا میشوند. لایهی dense به KV cache نیاز دارد، پس هر کدام یک ویفر کامل میگیرد.
- تعداد ویفر: ۳۵ ویفر برای لایههای linear و ۲۴ ویفر برای لایههای dense، جمعاً ۵۹ ویفر WSE-3T.
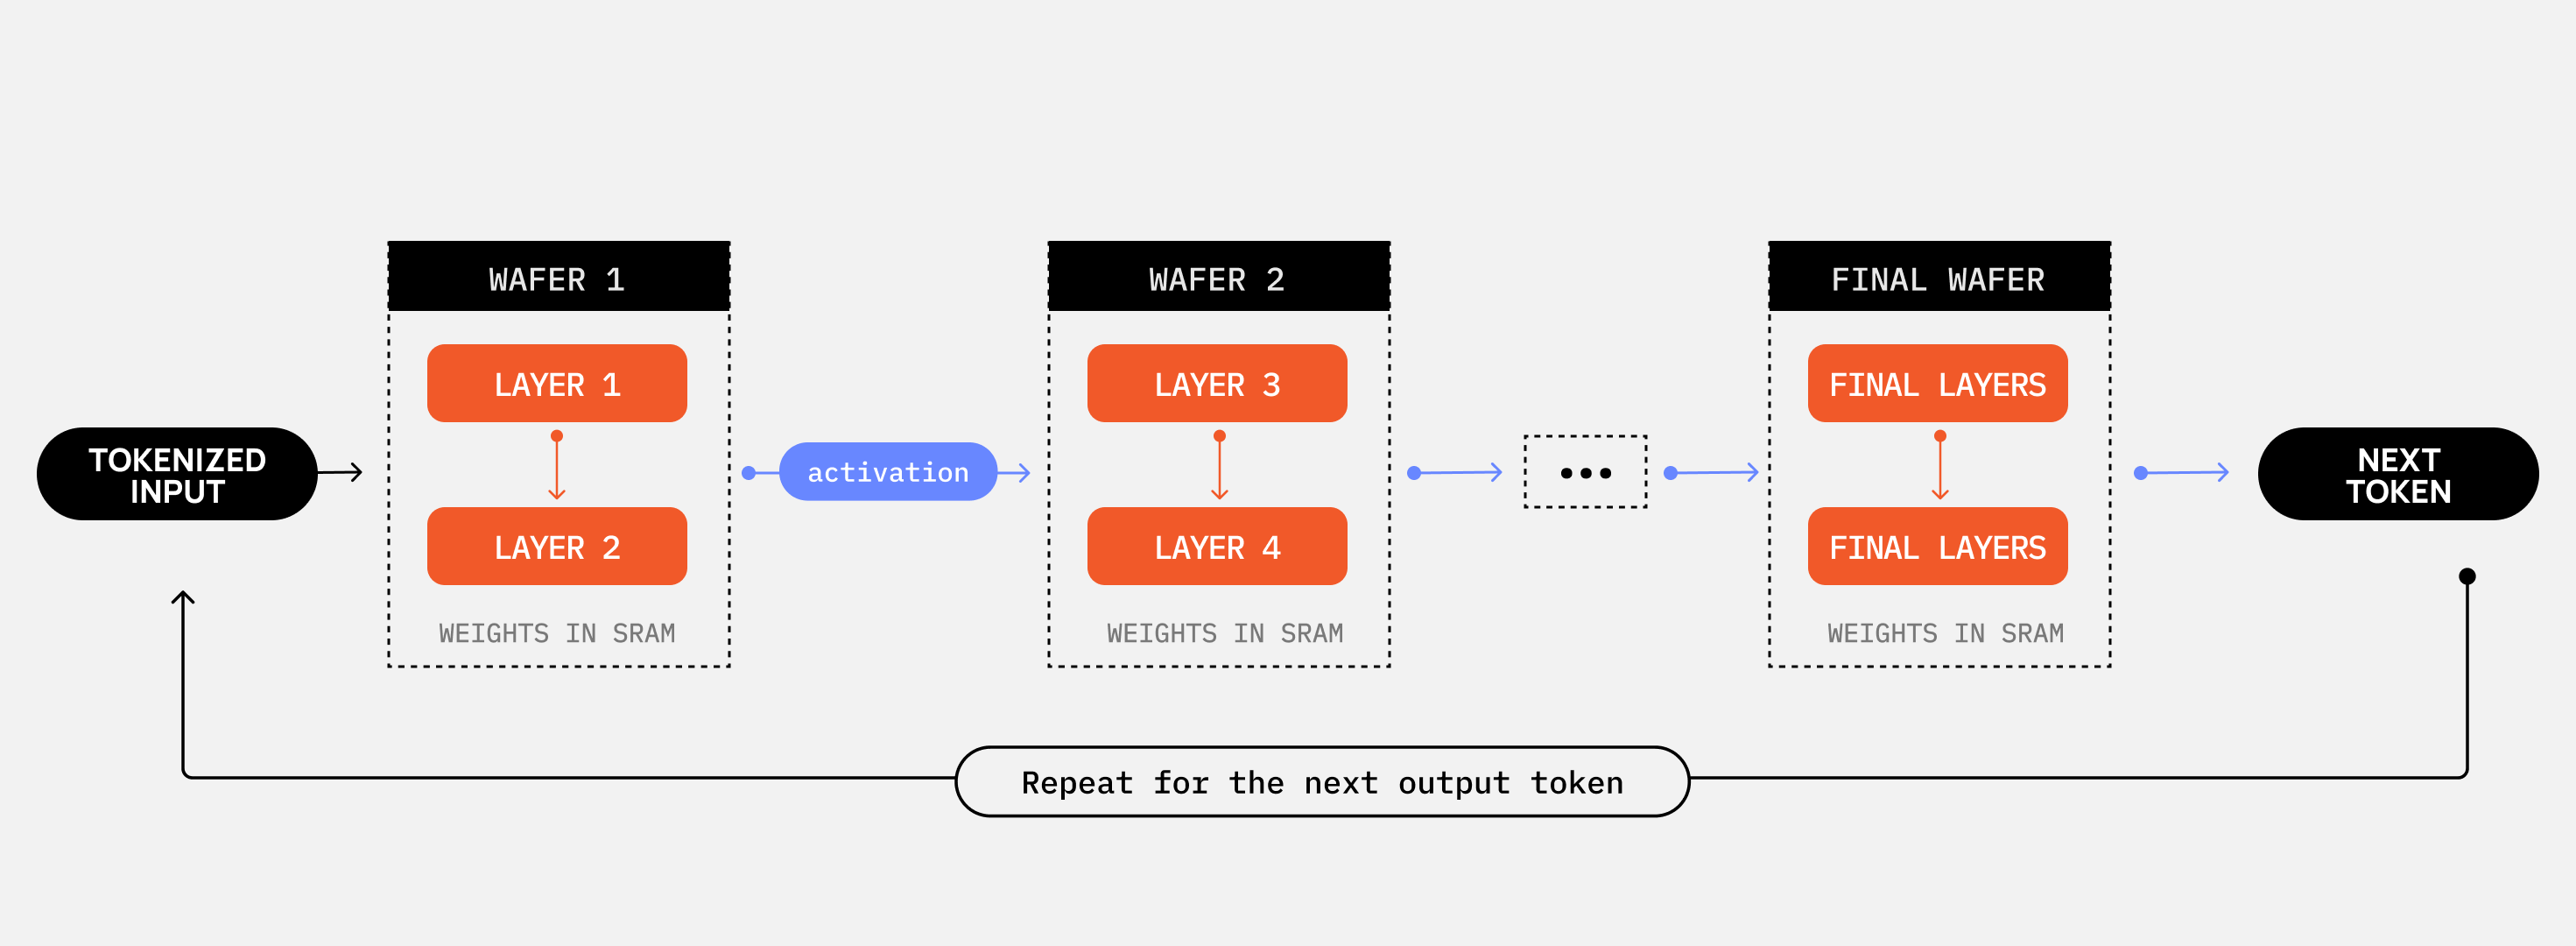
- وزنها تکان نمیخورند: چون هر لایه کامل روی چیپ جا میشود، فقط activationها با RDMA روی اترنت بین ویفرها رد میشوند، حدود ۲ میکروثانیه برای هر پرش.
پایپلاین، نه batch
هر ویفر مثل یک ایستگاه در خط تولید است: ویفر ۱ لایههای ۱ و ۲ را اجرا میکند و خروجی را به ویفر ۲ میدهد و همینطور تا آخر. برای اینکه ایستگاهها بیکار نمانند، خط همیشه پر از درخواستهای مختلف است؛ وقتی مرحلهی ۳ روی درخواست A کار میکند، مرحلهی ۲ روی B و مرحلهی ۱ روی C. هر مرحله هم میتواند یک micro-batch کوچک را پردازش کند.
سقف درخواستهای همزمان
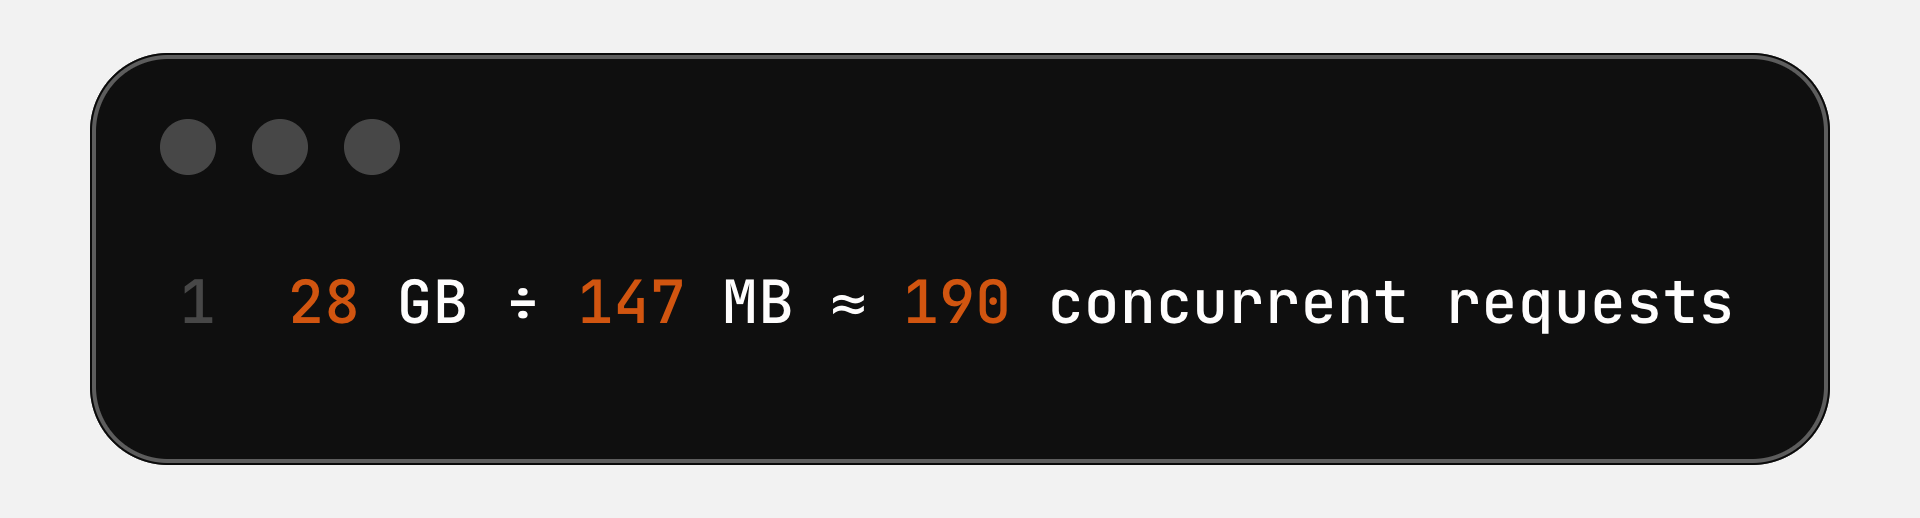
روی هر ویفر dense بعد از کم کردن ۱۶ گیگ وزن، ۲۸ گیگابایت برای KV cache میماند. هر درخواست ۲۵۶ هزار توکنی با KV cache هشتبیتی حدود ۱۴۷ مگابایت جا میگیرد، پس هر ویفر حدود ۱۹۰ درخواست همزمان را نگه میدارد. خود Cerebras هم تأکید میکند که معیار درست مقایسه، توکن بر ثانیه به ازای هر مگاوات در سرعت تولید یکسان است، نه batch size.
نظر من
این از آن پستهای مهندسی است که دوستشان دارم: بدون هیاهوی مارکتینگ، با عدد نشان میدهد معماری چطور کار میکند. نکتهی جالب برایم این است که معماری hybrid مدلهای جدید (لایههای linear-attention که KV cache ندارند) دقیقاً به نفع سختافزاری مثل Cerebras تمام میشود، چون حافظهی گران on-chip فقط خرج لایههای dense میشود.
ولی روی دیگر سکه را هم ببینید: ۵۹ ویفر برای سرو یک مدل، آن هم با فرض کوانتیزیشن ۴ بیتی، یعنی سرمایهگذاری سنگین و هزینهای که پست دربارهاش ساکت است. سرعت ۲۰۰۰ توکن در ثانیه برای ایجنتهای کدنویسی واقعاً بازی را عوض میکند، اما تا وقتی عدد توکن به ازای هر دلار یا هر مگاوات را کنار GPU نگذارند، نمیشود گفت این مسیر برای همه بهصرفه است. با این حال، رقابت در inference دقیقاً همان چیزی است که ما توسعهدهندهها لازم داریم.
منبع: بلاگ Cerebras · بحث هکرنیوز
Comments +
00No comments yet — be the first. هنوز نظری ثبت نشده؛ اولین نفر باش.