Kimi K3.1 Pro آمد: مدل open-weight سهتریلیونی که پا به پای Opus و GPT-6 میدود
Moonshot AI مدل Kimi K3.1 Pro را با context یک میلیون توکنی معرفی کرد؛ در Terminal-Bench 4.0 از GPT-6 Astra جلو زد و وزنهایش تا ۴ نوامبر منتشر میشود.
23 Oct 2026 · 3 min read · هوش مصنوعی · Kimi · Moonshot AI · مدل زبانی · Open Weight · LLM
Moonshot AI (سازندهی Kimi) امروز Kimi K3.1 Pro را معرفی کرد: اولین مدل سری K3.1 و به گفتهی خودشان قویترین مدل open-weight کلاس ۳ تریلیون پارامتریشان، با پنجرهی context یک میلیون توکنی. کنارش نسخهی K3.1 Pro Highspeed هم آمده که ۲ تا ۳ برابر سریعتر است. هر دو از امروز روی Kimi.ai، Kimi Work، Kimi Code و API در دسترساند و وزنهای کامل مدل تا ۴ نوامبر منتشر میشود.
چه چیزی عوض شده؟
K3.1 Pro در واقع همان K3 است با post-training بسیار سنگینتر. تیم Moonshot میگوید کل استک را بازنویسی کرده (فریمورک RL، استنتاج long-context، زیرساخت sandbox و زمانبندی rollout) تا بتوانند RL را همزمان روی صدها دامنه اجرا کنند و هر واحد compute بیشتر، نتیجهی قابل پیشبینی بدهد.
اعداد مهم
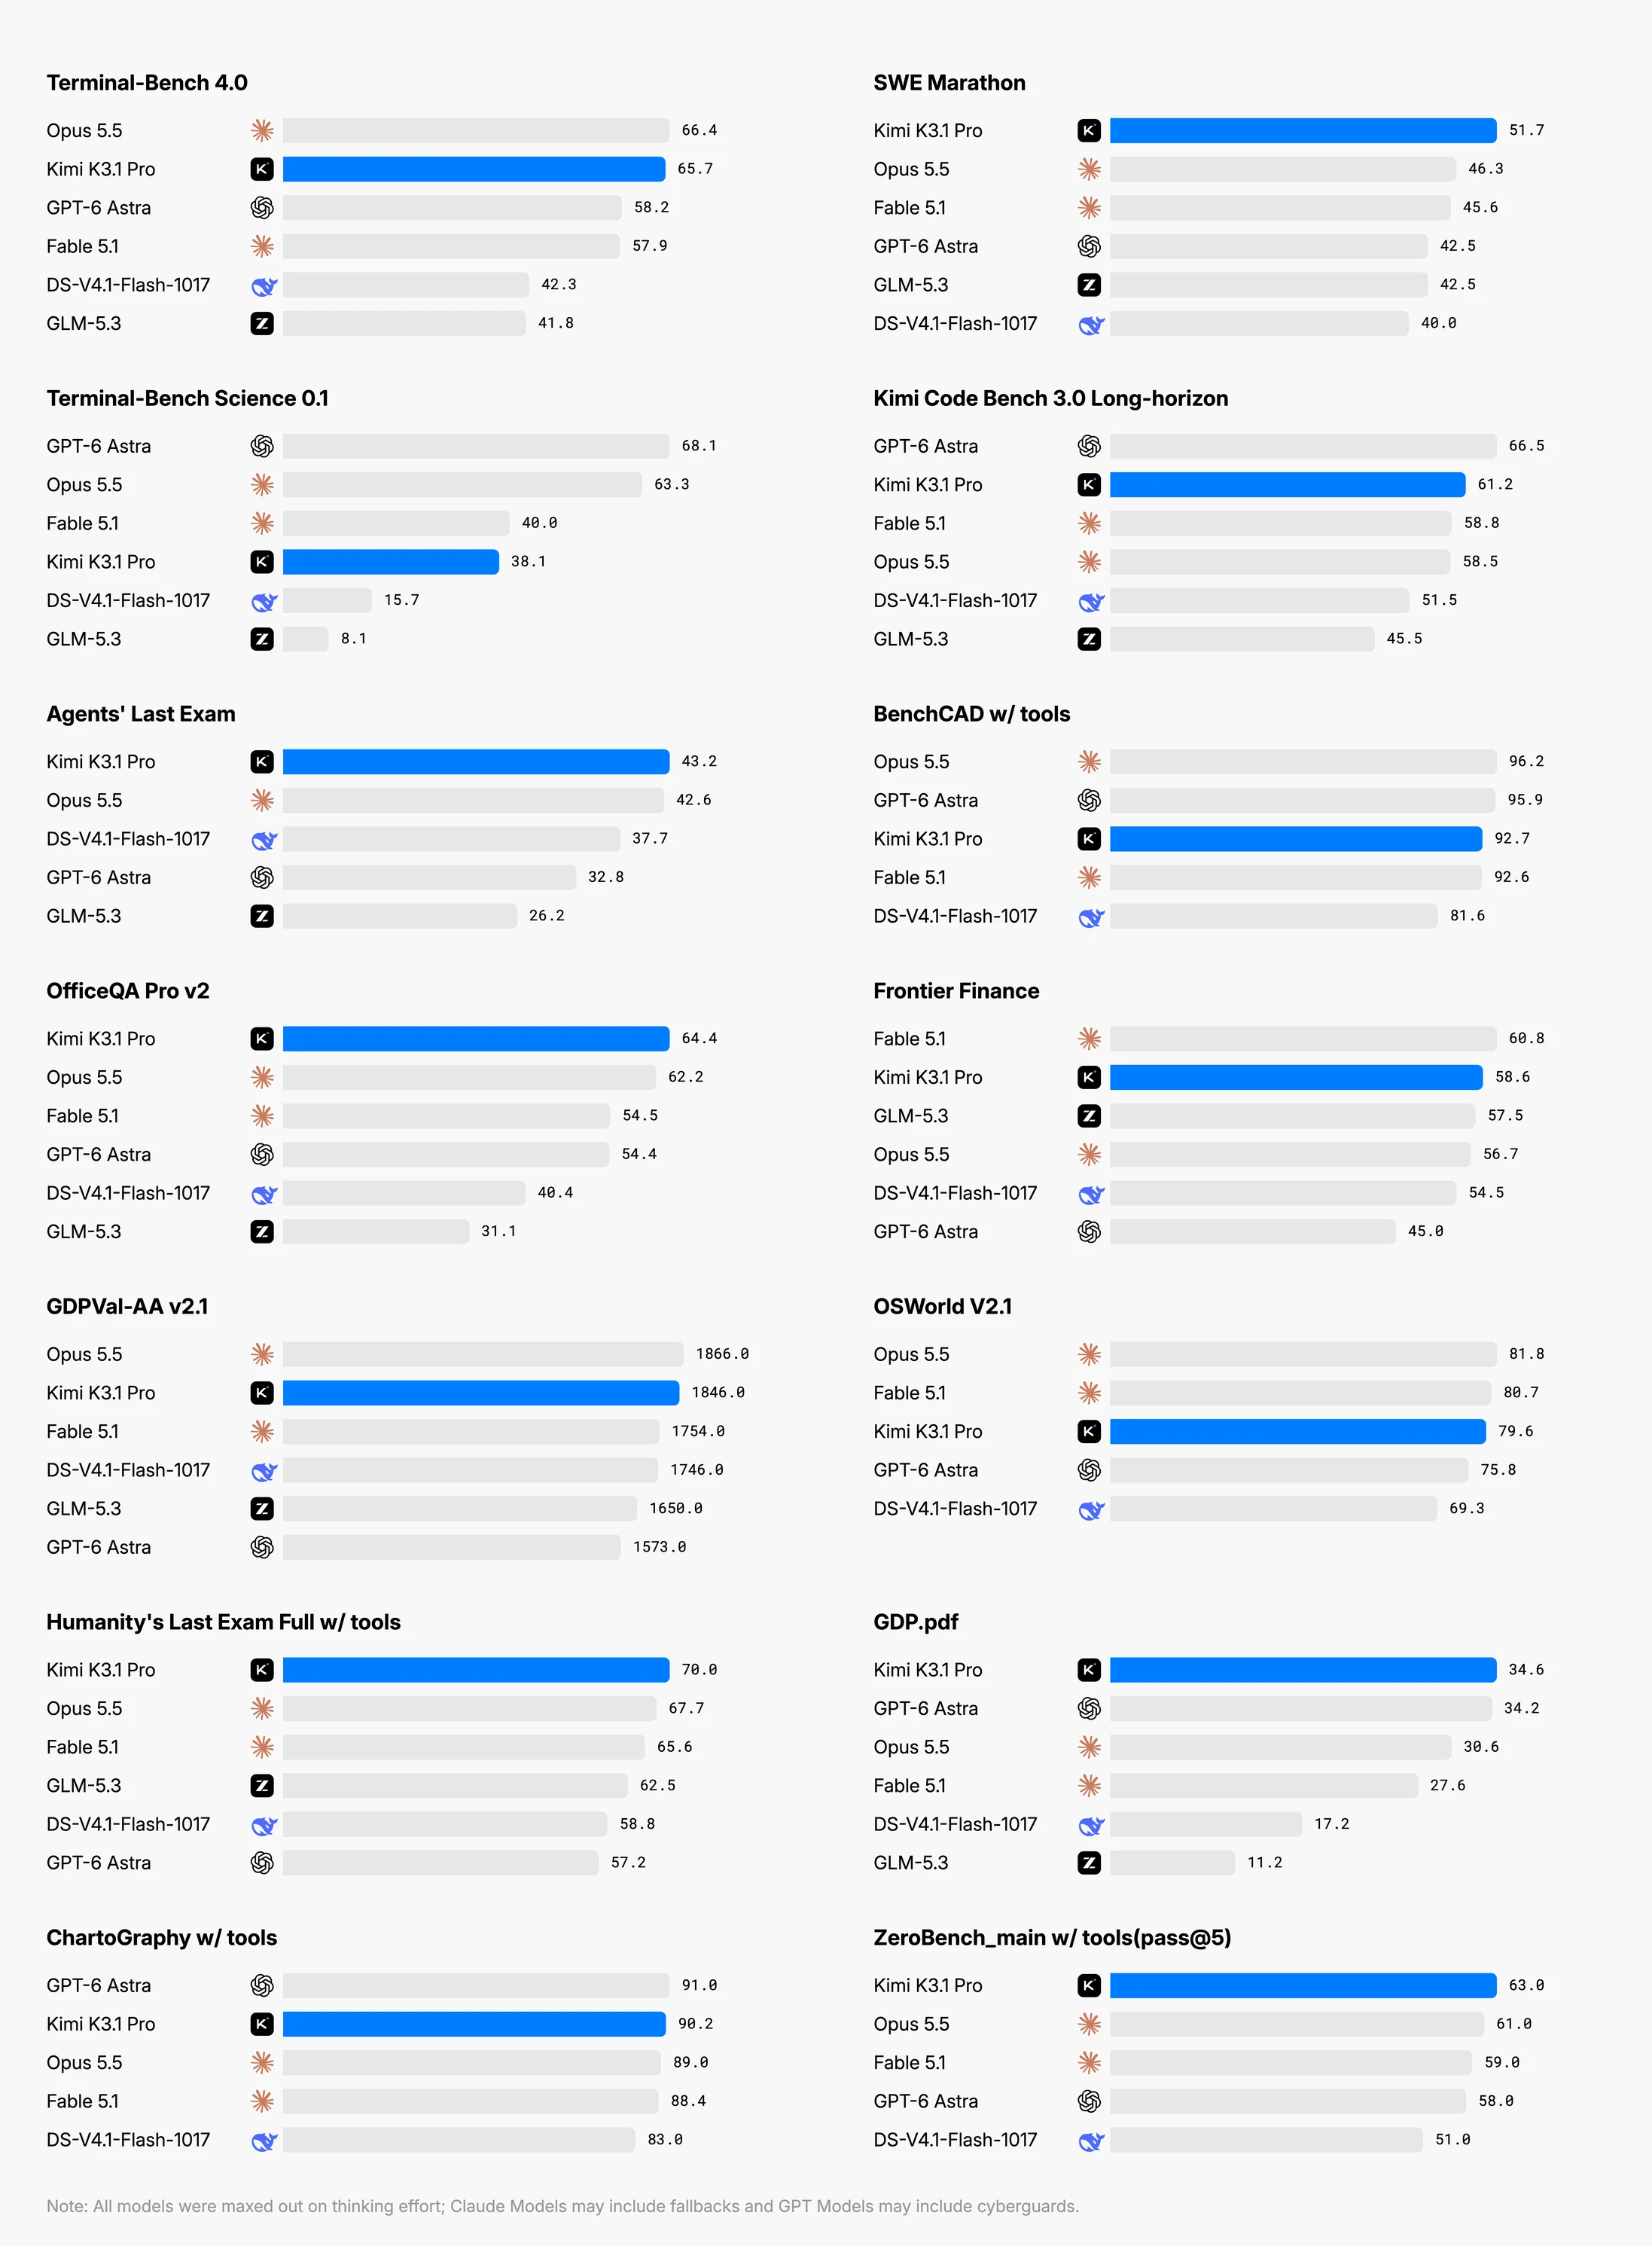
- Terminal-Bench 4.0: امتیاز ۶۵.۷٪؛ بالاتر از GPT-6 Astra (۵۸.۲٪) و فقط کمی پایینتر از Claude Opus 5.5 (۶۶.۴٪).
- Kimi Code Bench 3.0 (کارهای طولانی): ۶۱.۲٪ در برابر ۵۵.۹۵٪ برای K3. البته این بنچمارک داخلی خود Kimi است.
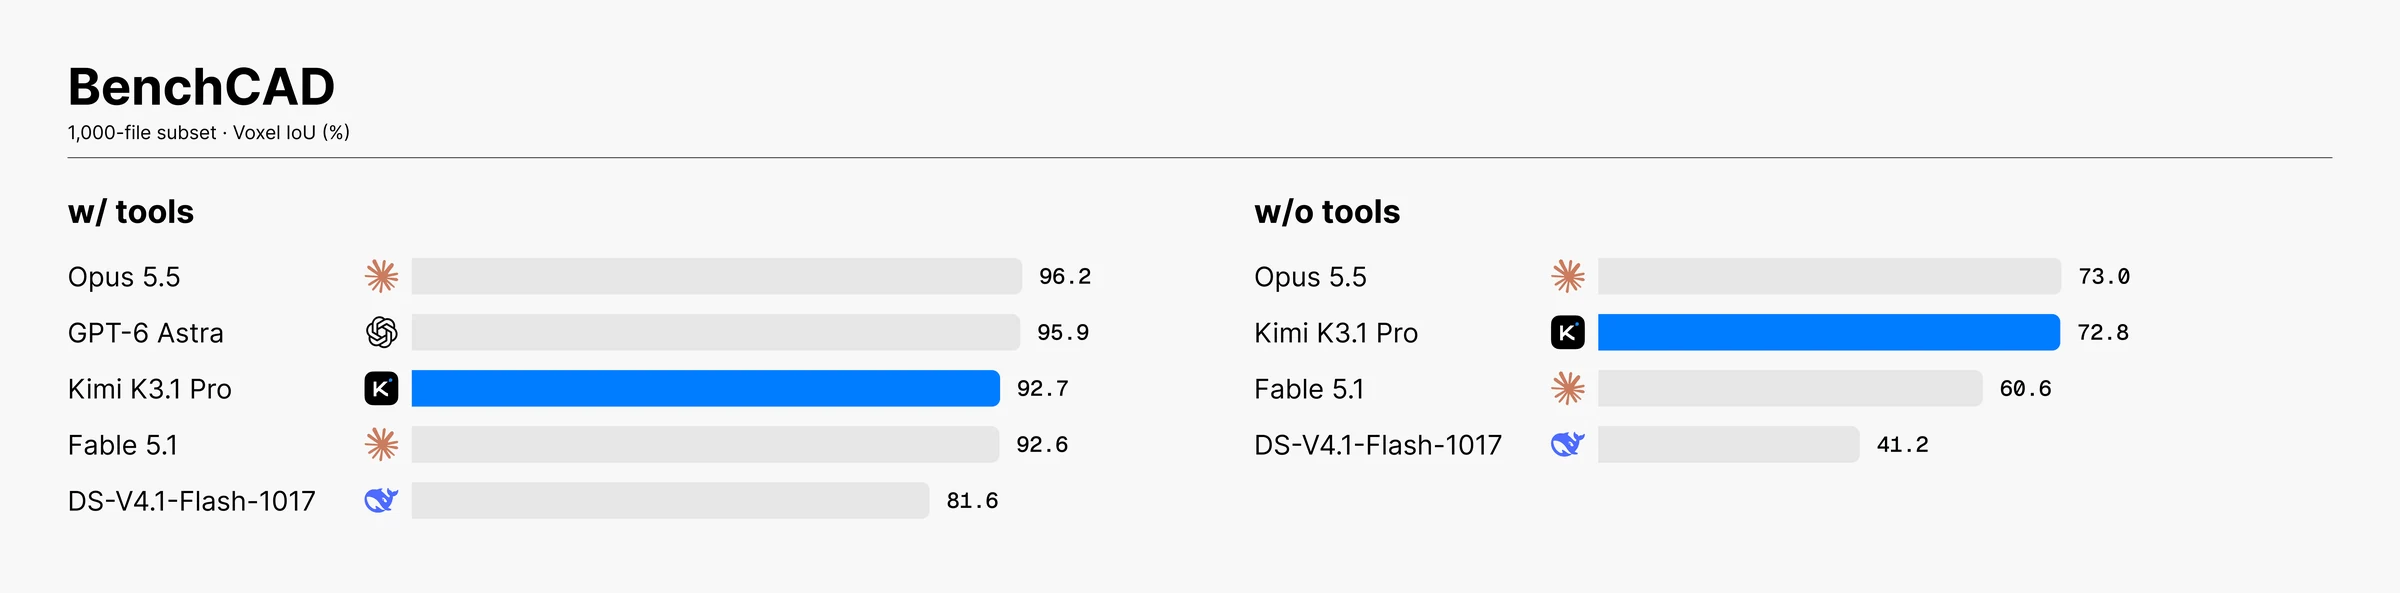
- BenchCAD (ساخت مدل سهبعدی با کد CAD): ۹۲.۷٪ با ابزار؛ نزدیک به Opus 5.5 (۹۶.۲٪) و GPT-6 Astra (۹۵.۹٪).
- OfficeQA Pro v2 (تحلیل اسناد مالی): ۶۴.۴، که به گفتهی خودشان state-of-the-art است.
در کدنویسی هم مثالهای جالبی آوردهاند: ساخت بازی با Unity، Unreal و Godot، صحنههای Three.js، و یک تست طولانی که مدل در آن یک شبیهساز راه رفتن انسان ساخت. در این تست، وقتی reward shaping جواب نداد، خودش دینامیک شبیهساز را بررسی کرد، ۳۶ خطا در محاسبات عضلات شانه پیدا و اصلاح کرد و دوباره کنترلر را آموزش داد.
توهم کمتر
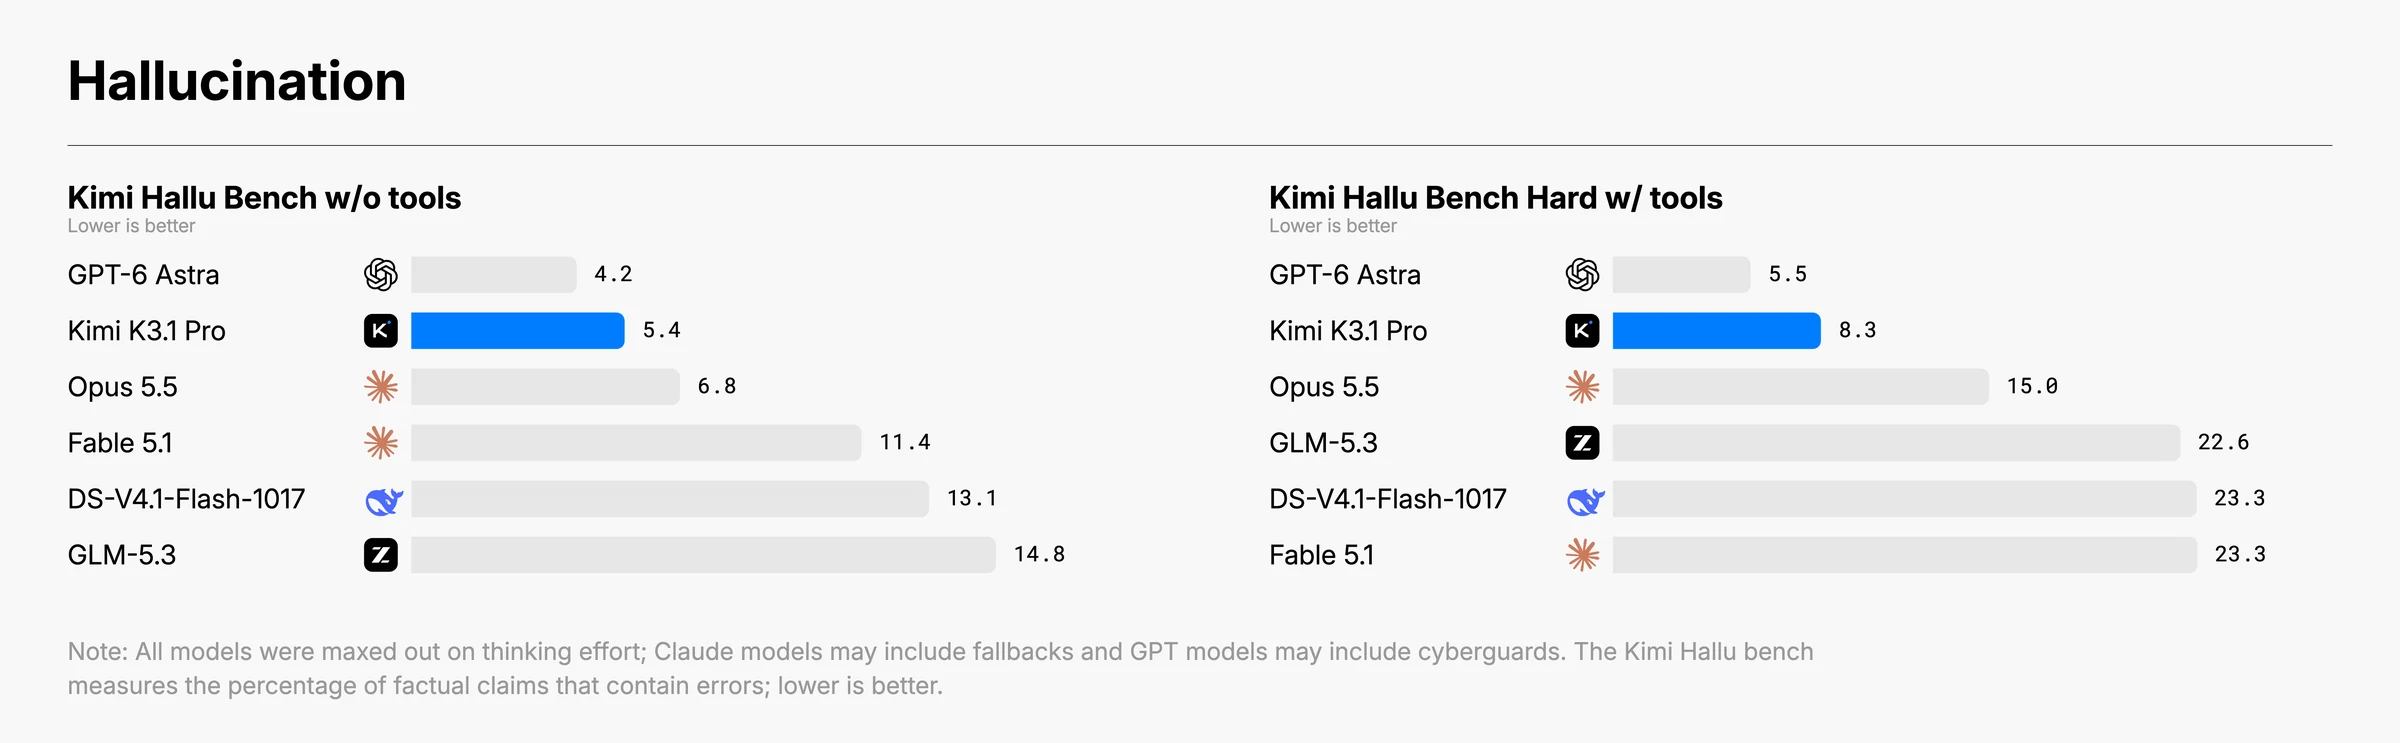
در بنچمارک داخلی Kimi Hallu Bench Hard، نرخ ادعاهای غلط از ۲۳.۴٪ در K3 به ۸.۳٪ رسیده است. خودشان هم تأکید میکنند که این یک stress test است و عدد خطای استفادهی روزمره نیست.
بخش جالب: عمداً مدل را در امنیت سایبری ضعیفتر کردند
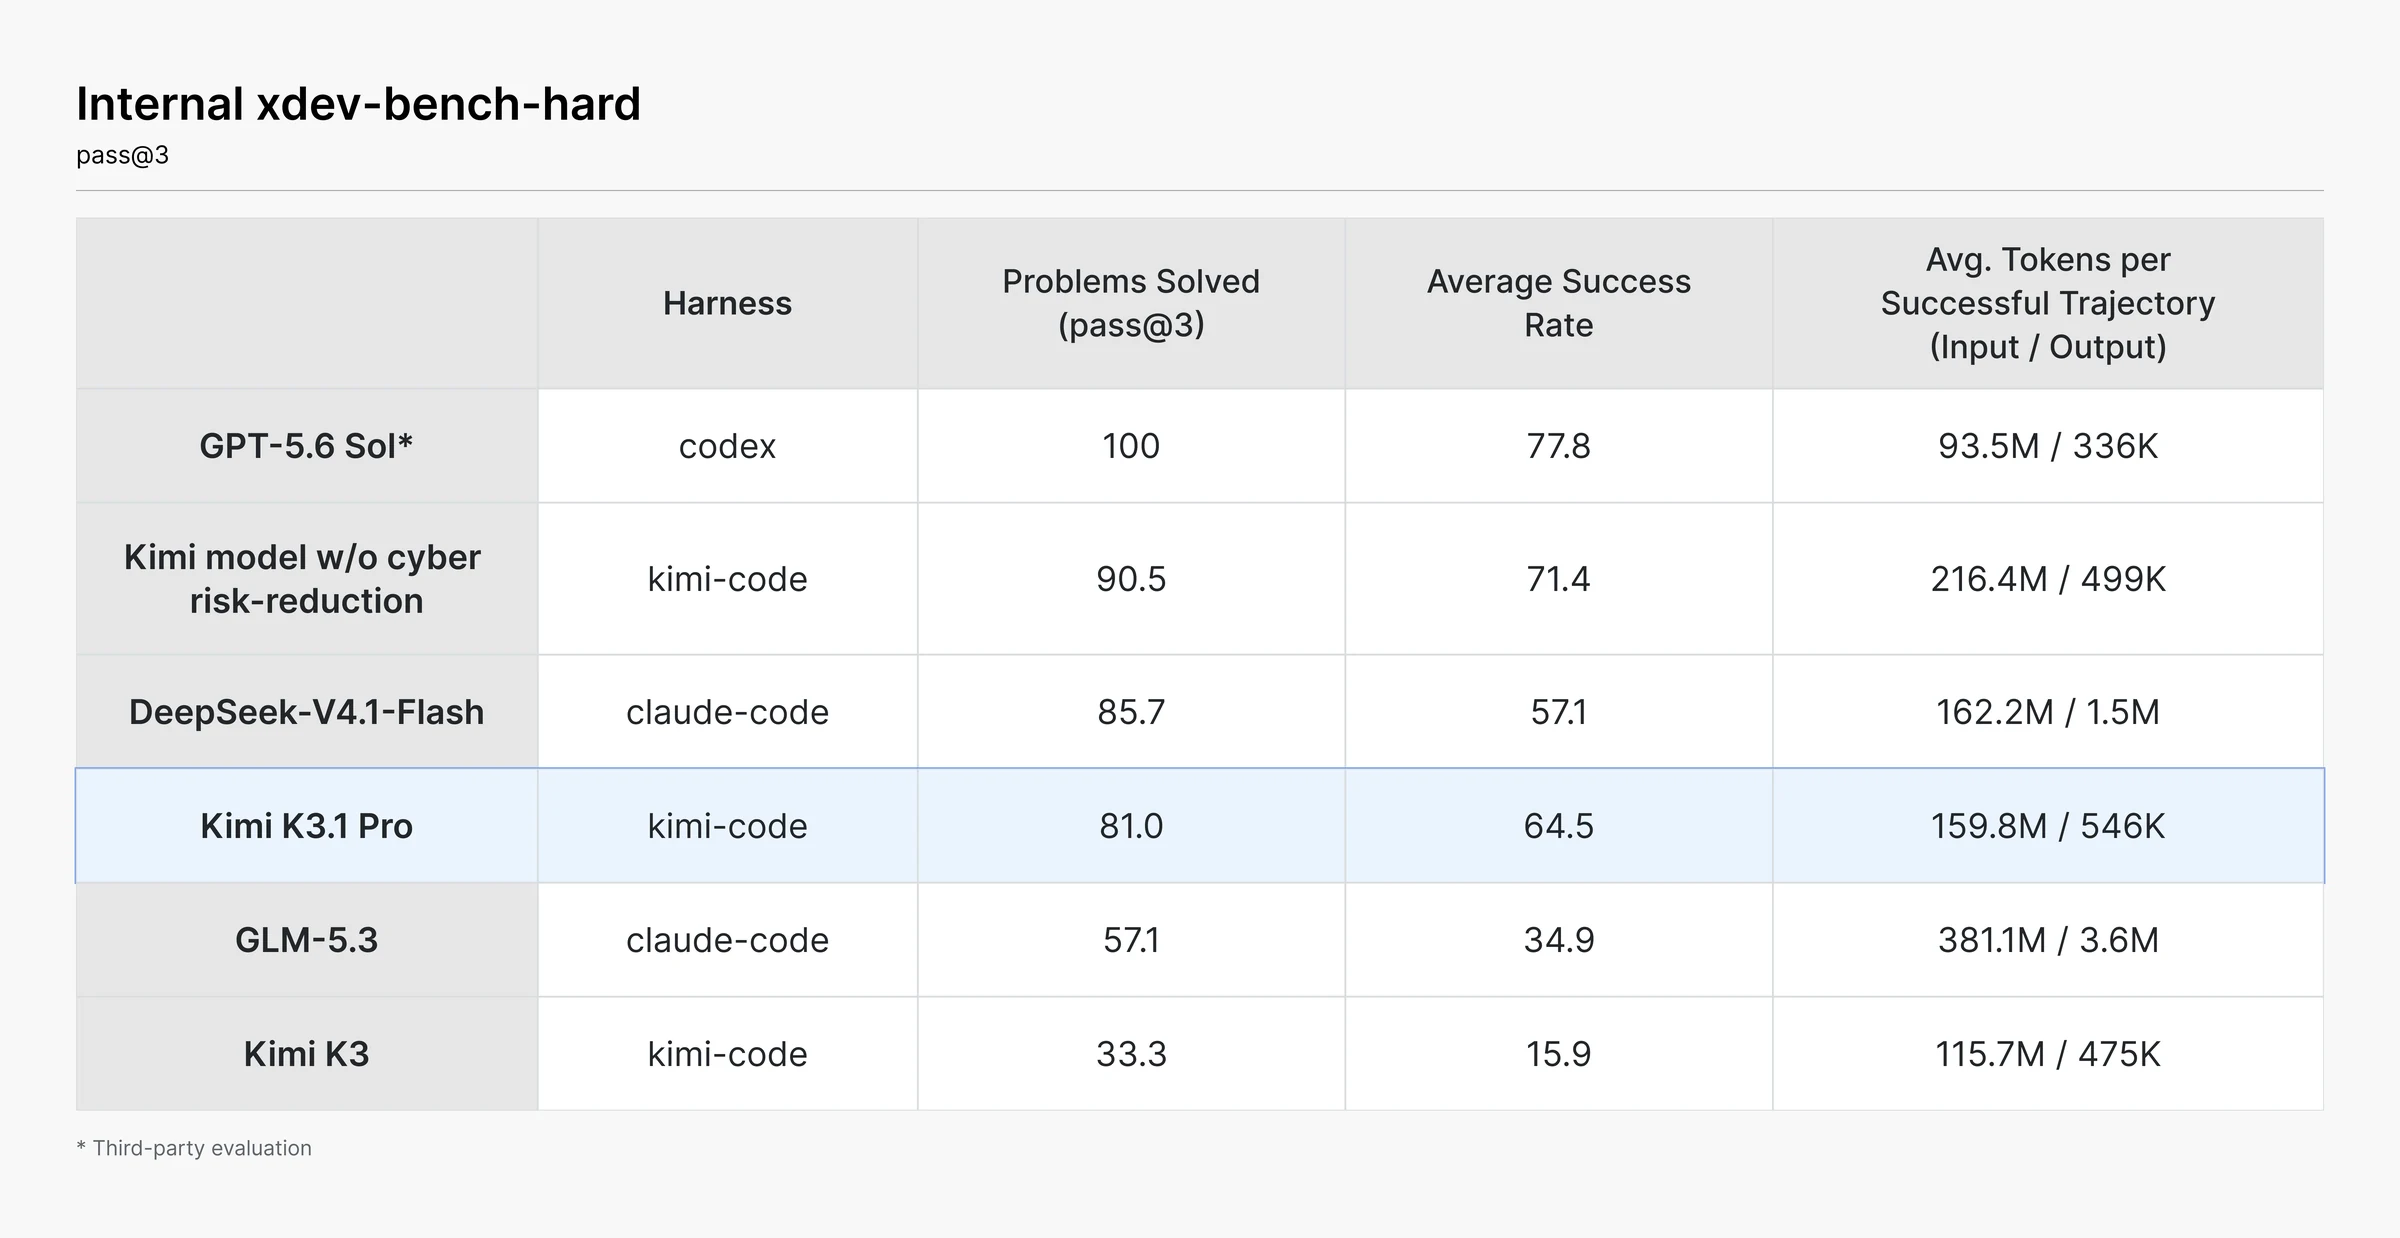
Moonshot میگوید برای نسخهی open-weight، دادههای مرتبط با امنیت سایبری را هم از mid-training و هم از محیطهای RL حذف کرده است. در بنچمارک xdev-bench-hard (نوشتن exploit واقعی برای آسیبپذیریهای لینوکس، Node.js، JavaScriptCore و غیره)، نسخهی بدون این محدودیتها ۹۰.۵٪ مسائل را حل میکرد و نسخهی نهایی ۸۱٪. یعنی هنوز خیلی قوی است، ولی به گفتهی خودشان از مدلهای بستهای که حداقل سه ماه است عرضه شدهاند عقبتر است.
نظر من
فاصلهی مدلهای open-weight با بهترین مدلهای بسته عملاً به چند درصد رسیده است. اینکه یک مدل باز در Terminal-Bench از GPT-6 Astra جلو بزند و پشت سر Opus 5.5 باشد، خبر کوچکی نیست. برای کسی که میخواهد ایجنت کدنویسی را روی زیرساخت خودش اجرا کند، K3.1 Pro احتمالاً جدیترین گزینهی فعلی است.
ولی دو نکته را فراموش نکنید. اول، بخشی از بهترین عددها مال بنچمارکهای داخلی خود Kimi است و تا تست مستقل نیاید، باید با احتیاط نگاهشان کرد. دوم، مدل ۳ تریلیون پارامتری «باز» است، ولی اجرای محلیاش برای اکثر ما رؤیاست؛ در عمل بیشتر از طریق API یا ارائهدهندههای ثالث به کارمان میآید.
بخش امنیت سایبری را هم دوست داشتم: شفاف گفتهاند چه چیزی را حذف کردهاند و چقدر اثر داشته. این دقیقاً همان بحثی است که این روزها با موج exploitهای ساختهشده با هوش مصنوعی داغ شده، و خوب است یک آزمایشگاه open-weight عدد واقعی رو کند.
Comments +
00No comments yet — be the first. هنوز نظری ثبت نشده؛ اولین نفر باش.