لپتاپهای Nvidia RTX Spark بنچمارک شدند: سریعترین لپتاپ ویندوزی برای AI محلی، با قیمتی سنگین
اولین بررسیهای لپتاپهای RTX Spark با تراشهی N1X منتشر شد: تا ۱۲۸ گیگ حافظهی یکپارچه و عملکرد عالی در اجرای LLM محلی با llama.cpp، ولی گرمای زیاد زیر بار پیوسته و قیمت ۲۶۰۰ تا بیش از ۶۰۰۰ دلار.
17 Oct 2026 · 3 min read · Nvidia · RTX Spark · لپتاپ · هوش مصنوعی محلی · llama.cpp · LLM · ویندوز آرم

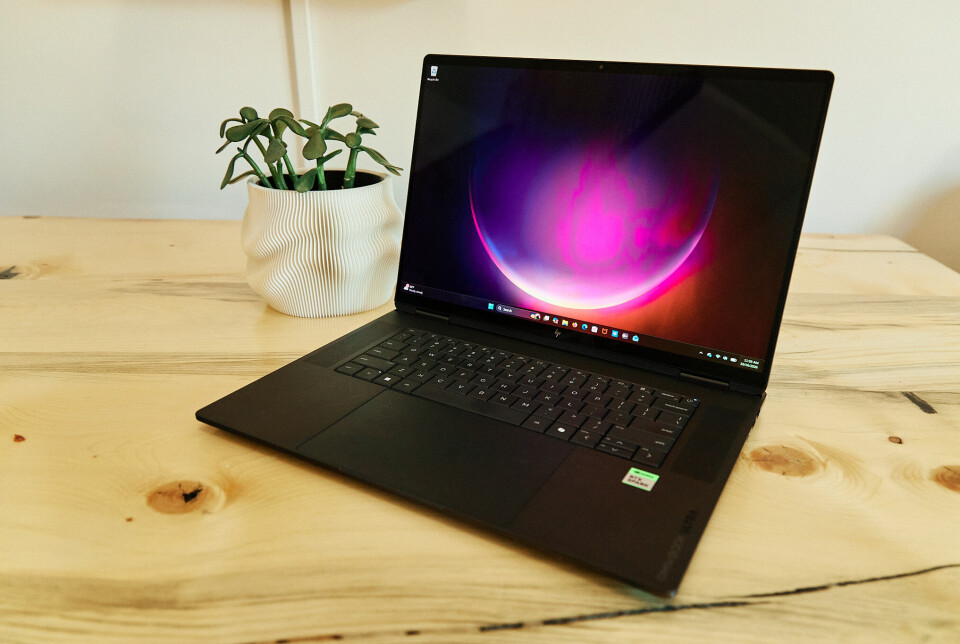
لپتاپهای Nvidia RTX Spark بالاخره به دست رسانهها رسیدهاند و اولین بررسیهای جدی منتشر شده. The Register نسخهی HP OmniBook Ultra 16 را زیر بنچمارکهای AI محلی برده و The Verge هم یک هفته با لپتاپهای ASUS، HP و Lenovo کار کرده. خلاصهی ماجرا: برای اجرای مدلهای زبانی روی لپتاپ ویندوزی، فعلاً چیزی سریعتر از این پیدا نمیکنید؛ ولی قیمتها از حدود ۲۶۰۰ دلار شروع میشود و نسخههای بالا از ۶۰۰۰ دلار هم رد میشوند.
زیر کاپوت: همان GB10، این بار روی ویندوز
قلب این لپتاپها تراشهی N1X است: یک چیپلت CPU آرم که از MediaTek گرفته شده و با اتصال NVLink Fusion به یک GPU بلکول وصل شده. نسخهی پایه ۱۸ هستهی CPU و ۵۱۲۰ هستهی CUDA دارد و نسخهی بالاتر ۲۰ هستهی CPU (نیمی Arm X925 و نیمی Cortex A725) و ۶۱۴۴ هستهی CUDA؛ یعنی دقیقاً هماندازهی RTX 5070، ولی با دسترسی به تا ۱۲۸ گیگابایت حافظهی یکپارچه.
به گفتهی The Register، N1X در واقع همان GB10 است که بیش از یک سال پیش در DGX Spark لینوکسی عرضه شد؛ با این تفاوت که پهنای باند حافظه از ۲۷۳ به حدود ۳۰۰ گیگابایت بر ثانیه رسیده، که مستقیم روی سرعت تولید توکن اثر دارد.
بنچمارکهای AI محلی
- تستها با llama.cpp نسخهی 0.6.0 روی پنج مدل از Meta، گوگل و علیبابا، از حدود ۲۶ تا ۱۲۲ میلیارد پارامتر انجام شد.
- در Qwen3.6-35B-A3B، سریعترین مدل تست، حافظهی سریعتر N1X در تولید توکن از DGX Spark جلو زد؛ هر دو سیستم انویدیا هم از AMD Strix Halo سریعتر بودند، هرچند AMD همچنان ارزش خرید بهتری دارد.
- در یک تست کدنویسی ایجنتی با Qwen Code، مدل بزرگتر Qwen3.5-122B-A10B با اینکه تقریباً با نصف سرعت توکن تولید میکرد، بهطور میانه حدود ۴۰ ثانیه زودتر مسئله را حل کرد، چون توکن خیلی کمتری لازم داشت.
- یک نکتهی آزاردهنده: ویندوز برخلاف لینوکس حافظه را پویا به GPU نمیدهد و لپتاپ HP با تقسیم ثابت ۶۴ به ۶۴ گیگ آمده بود. llama.cpp میتواند به حافظهی CPU سرریز کند و چون حافظه مشترک است، جریمهاش زیاد نیست.

گرما: پاشنهی آشیل لپتاپ نازک
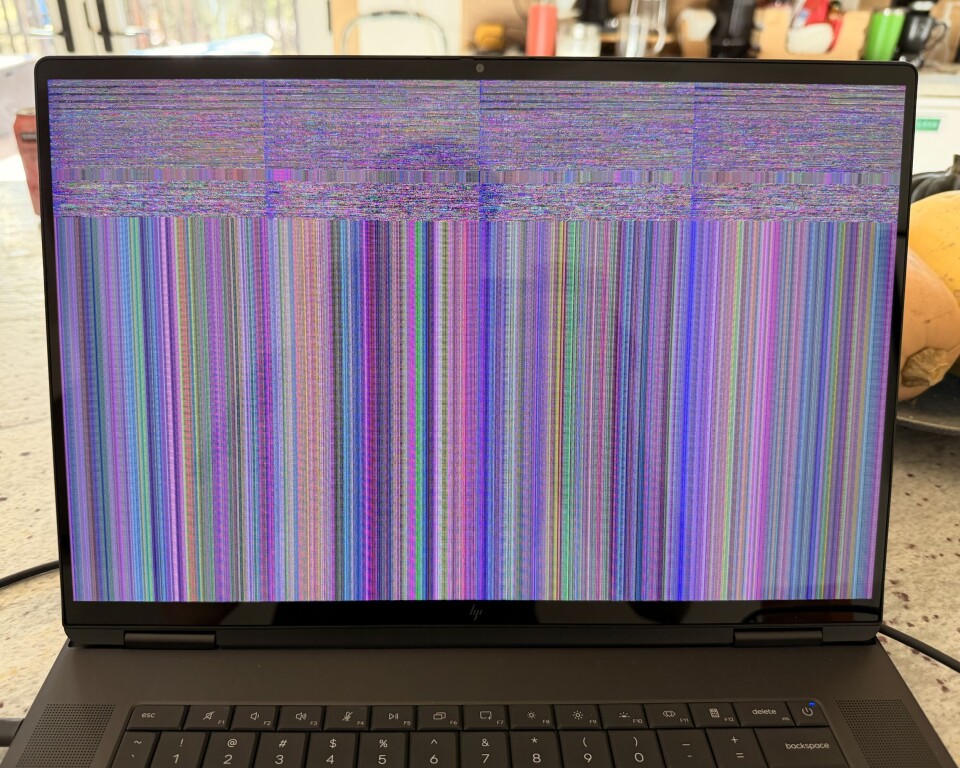
زیر بار پیوستهی AI، دمای GPU در حدود یک ساعت از ۹۰ درجهی سانتیگراد بالاتر رفت و The Register چند بار هنگ کردن و یک بار آرتیفکت گرافیکی دید. در استفادهی واقعی، حتی چند ثانیه مکث بین پرامپتها کافی بود تا سیستم پایدار بماند؛ ولی اگر میخواهید روی آن fine-tune کنید، توصیهشان DGX Spark یا ورکاستیشنهای GB10 با خنککاری بهتر است.
گیم و تجربهی روزمره
The Verge میگوید اپهای روزمره روی ویندوز آرم دیگر مشکلی ندارند و GPU انویدیا لایهی شبیهسازی را در بازیها جبران میکند: Black Myth: Wukong با تنظیمات متوسط و DLSS حدود ۷۰ فریم و Cyberpunk 2077 حدود ۶۶ فریم. ولی بازیهای CPU-محور مثل Helldivers 2 هنوز اذیت میکنند.

نظر من
RTX Spark اولین لپتاپ ویندوزی است که واقعاً میشود رویش یک مدل کدنویسی جدی را محلی اجرا کرد و برای خیلیها جایگزین Claude Code یا Codex ابری شد. برای کسی که CUDA میخواهد و نمیخواهد به اکوسیستم اپل برود، جذاب است. اما با قیمت ۳۲۰۰ تا بیش از ۶۲۰۰ دلار و گرانی فعلی حافظه، به نظرم برای اکثر برنامهنویسها منطقی نیست؛ همان پول، سالها اشتراک API میخرد.
نکتهی جالبتر برای من نتیجهی تست ایجنتی است: مدل بزرگتر و کندتر زودتر مسئله را حل کرد. یعنی «توکن بر ثانیه» معیار گمراهکنندهای است و چیزی که مهم است، تعداد توکن تا جواب درست است. اگر بخواهم بخرم، نسخهی ۶۴ گیگ را میگیرم و مدلهای ۲۰ تا ۶۰ میلیارد پارامتری؛ همان نقطهی بهینهای که خود The Register هم پیشنهاد میکند. و اگر fine-tune کار اصلیتان است، لپتاپ نازک انتخاب درستی نیست.
Comments +
00No comments yet — be the first. هنوز نظری ثبت نشده؛ اولین نفر باش.